Einfache Pay-as-you-go-Preise für die Assistant-Cortex-Cloud
Ihre Assistant-Cortex-Instanz kommt mit einem Marktplatz vorgefertigter Anwendungen und KI-Tools — und einem einfachen Abrechnungsmodell: Guthaben aufladen, und monatliche Seat-Gebühren sowie nutzungsabhängige Kosten werden laufend abgezogen. Keine Verträge, keine Feature-Stufen, und jede neue Instanz startet mit 20 $ Startguthaben.
Brauchen Sie mehr als eine Instanz? Dieselbe Codebasis, die unsere Cloud betreibt, kann lizenziert werden, um Ihr eigenes maßgeschneidertes SaaS-Produkt zu bauen — siehe Enterprise-Bereitstellung unten.
Pay As You Go
Installieren Sie die gewünschten Anwendungen und KI-Tools aus dem Marktplatz und zahlen Sie nur für das, was Sie nutzen. Laden Sie Guthaben auf Ihr Konto, und monatliche wie nutzungsabhängige Kosten werden von diesem Guthaben abgezogen. Jede Assistant-Cortex-Instanz kommt mit 20 $ Startguthaben zum Ausprobieren. Kontaktieren Sie den Vertrieb, um noch heute Ihre Instanzen zu erhalten.
Kreditkartenzahlung
Wir akzeptieren alle gängigen Kreditkarten, darunter American Express, Visa, Mastercard und Discover. Mindestbetrag beim Aufladen: 5 $.
Automatisches Aufladen
Ihre Assistant-Cortex-Instanz lässt sich so konfigurieren, dass das Guthaben automatisch aufgeladen wird, sobald eine einstellbare Schwelle erreicht ist.
Monatliche Gebühren
Einige Leistungen von Assistant Cortex werden im Abonnement abgerechnet. Diese Leistungen werden pro Seat berechnet.
Benutzerkonten
Jedes Benutzerkonto kostet 39,99 $ pro Monat; die Gebühr wird monatlich an dem Tag abgezogen, an dem das Konto erstellt wurde. Das erste Admin-Konto ist kostenlos, bis das anfängliche Startguthaben von 20 $ aufgebraucht ist — danach wird es als regulärer Seat berechnet.
Telefonnummern
Jede Telefonnummer kostet 3,99 $ pro Monat; die Gebühr wird monatlich an dem Tag abgezogen, an dem die Nummer zugewiesen wurde.
Nutzungsabhängige Preise
Einige Leistungen von Assistant Cortex werden nach Nutzung abgerechnet. Dazu gehören KI-Modelle und Kommunikationsdienste wie Textnachrichten.
Assistant Cortex Modellpreise
Preisinformationen für alle verfügbaren KI-Modelle und APIs.
| Modell | Kategorie | Eingabepreis | Ausgabepreis |
|---|---|---|---|
| Ace Step | Sonstige | 0.000200 | 0.000200 |
| Claude Sonnet 4 | Sprachmodelle | 3.60 | 18.00 |
| Flux Fill Pro | Bildgenerierung | — | 0.0200 |
| Flux Kontext Dev | Bildgenerierung | 0.0480 | 0.0480 |
| Flux Kontext Pro | Bildgenerierung | — | 0.0200 |
| Flux Pro 2 Edit | Bildgenerierung | 0.0480 | 0.0480 |
| Flux Pro | Bildgenerierung | — | 0.0200 |
| Gemini 3.1 Pro Preview | Sprachmodelle | 2.00 | 12.00 |
| Gemini 3.7 Flash | Sprachmodelle | 0.7500 | 3.75 |
| Gemini Flash | Sprachmodelle | 0.1200 | 0.4800 |
| Gemini Pro | Sprachmodelle | 0.1200 | 3.60 |
| Hunyuan 3D v3.1 Pro – FAL.ai | 3D-Generierung | — | 0.3750 |
| MiniMax H3 Max Reference-to-Video | Sonstige | — | 0.0800 |
| Mistral Large | Sprachmodelle | 0.5000 | 1.50 |
| OpenAI GPT-4o | Sprachmodelle | 0.000600 | 0.000600 |
| OpenAI GPT-5 | Sprachmodelle | 0.7500 | 6.00 |
| OpenAI GPT-5.4 Mini | Sprachmodelle | 0.3600 | 0.3600 |
| OpenAI GPT-5.5 | Sprachmodelle | 5.00 | 30.00 |
| OpenAI GPT-5.6 Sol | Sprachmodelle | 4.00 | 20.00 |
| OpenAI GPT-6 Astra | Sprachmodelle | 10.00 | 50.00 |
| Claude Opus 4.8 | Sprachmodelle | 5.00 | 25.00 |
| Claude Opus 5 | Sprachmodelle | 5.00 | 25.00 |
| Claude Sonnet 4 | Sprachmodelle | 0.001200 | 0.003600 |
| DeepSeek 31 | Sprachmodelle | 0.3400 | 0.5000 |
| DeepSeek V4 Pro | Sprachmodelle | 0.6600 | 1.98 |
| GPT-6 Astra | Sprachmodelle | 10.00 | 50.00 |
| Qwen 3.5 | Sprachmodelle | 0.3900 | 2.34 |
| Qwen 3.8 | Sprachmodelle | 2.00 | 6.00 |
| Qwen 3.8 Max | Sprachmodelle | 2.00 | 6.00 |
| Qwen3 235B | Sprachmodelle | 0.2800 | 2.34 |
| Qwen3 Coder | Sprachmodelle | 0.2800 | 2.34 |
| Qwen Image Edit 25511 | Sprachmodelle | 90000.00 | 90000.00 |
| Hyper3D Rodin v2.5 – FAL.ai | Sonstige | — | 0.4000 |
| Tripo 3D | 3D-Generierung | — | 0.4000 |
| VibeVoice 7B – FAL.ai | Audio-Modelle | — | 0.000667 |
| VibeVoice TTS | Audio-Modelle | — | 0.0480 |
| Wan 2.1 1B | Sonstige | 0.2400 | 0.2400 |
| AceStep V1.5 Turbo | Audio-Modelle | 0.000240 | 0.000240 |
| CLIP ViT Large Patch14 | Vision-Modelle | 0.000264 | 0.000264 |
| Dream Shaper Image Gen | Bildgenerierung | 0.002900 | 0.002900 |
| Flux 1 Dev Kontext | Bildgenerierung | — | 0.0200 |
| Flux 2 Dev Klein 4B | Bildgenerierung | 0.009000 | 0.009000 |
| Flux 2 Dev Klein 9B | Bildgenerierung | 0.009000 | 0.009000 |
| GLM 4.5 Air | Sprachmodelle | 0.1560 | 1.02 |
| GLM 4.5 Air Bartowski | Sprachmodelle | 0.7200 | 2.64 |
| Groq GPT-OSS 120B | Sprachmodelle | 0.1500 | 0.6000 |
| Groq Qwen 3.8 27B | Sprachmodelle | 0.8000 | 4.00 |
| Hunyuan 3D 2 | 3D-Generierung | 0.1920 | 0.1920 |
| Intel DPT Large | Sonstige | 0.000264 | 0.000264 |
| Juggernaut XL Image Gen | Bildgenerierung | — | 0.0200 |
| Laion CLAP Larger CLAP General | Sonstige | 0.000264 | 0.000264 |
| LTX-2 | Bildgenerierung | — | 0.2000 |
| Media Utils | Sonstige | 0.003000 | 0.003000 |
| Meta SAM2.1 Hiera Large | Vision-Modelle | 0.0252 | 0.0252 |
| OWLViT Base Patch16 | Vision-Modelle | 0.000264 | 0.000264 |
| OWLViT Large Patch14 | Vision-Modelle | 0.000264 | 0.000264 |
| Qwen3 30B A3B | Sprachmodelle | 0.000400 | 0.000200 |
| Qwen3 32B | Sprachmodelle | 0.001200 | 0.000800 |
| Qwen3 Coder Next 80B | Sprachmodelle | 0.2800 | 2.34 |
| Qwen3 Embedding 0.6B | Sprachmodelle | — | 2000.00 |
| Qwen 2.5 VL 32B | Sprachmodelle | 0.001200 | 0.000800 |
| Qwen 2.5 VL 7B | Sprachmodelle | 0.2800 | 2.34 |
| Qwen 3 VL 32B | Sprachmodelle | 0.2800 | 2.34 |
| Qwen 3 VL 4B | Sprachmodelle | 0.3120 | 3.12 |
| Qwen 3 VL 8B | Sprachmodelle | 0.2800 | 2.34 |
| Qwen Image Edit | Sprachmodelle | 90000.00 | 90000.00 |
| Qwen Image Edit 2509 | Sprachmodelle | 90000.00 | 90000.00 |
| ResNet-50 | Vision-Modelle | 0.000264 | 0.000264 |
| SAM Audio Large | Vision-Modelle | — | 0.0200 |
| Stable Audio Open 1 | Bildgenerierung | — | 0.0200 |
| Tesseract OCR | Vision-Modelle | 0.000264 | 0.000264 |
| VibeVoice ASR Base | Audio-Modelle | — | 0.0000070000 |
| vLLM GLM Air 35 | Sprachmodelle | 0.7200 | 2.64 |
| vllm_qwen3_5_35b_a3b_1 | Sprachmodelle | 0.2500 | 1.00 |
| vLLM Qwen Qwen3.5 35B A3B | Sprachmodelle | 0.4000 | 4.00 |
| Wan 2.2 I2V | Sonstige | 0.1920 | 0.1920 |
| Whisper Medium | Audio-Modelle | — | 0.0000070000 |
| Whisper Medium EN | Audio-Modelle | — | 0.0000070000 |
| Whisper Small EN | Audio-Modelle | — | 0.0000070000 |
| Whisper Tiny EN | Audio-Modelle | — | 0.0000070000 |
| YOLOS Small | Vision-Modelle | 0.000264 | 0.000264 |
| ZImage Turbo | Bildgenerierung | 0.006000 | 0.006000 |
Speicher
Die gespeicherten Daten Ihrer Instanz werden stündlich gemessen und als einfache Tagesgebühr von Ihrem Guthaben abgerechnet, anteilig pro Gigabyte-Monat — Sie zahlen nur für das, was Sie tatsächlich speichern.
| Dateispeicher (Workspaces, Uploads, generierte Medien) | 0,023 $ pro GB-Monat |
| Datenbankspeicher (MySQL) | 0,115 $ pro GB-Monat |
| Such- & Embedding-Speicher (Elasticsearch) | 0,122 $ pro GB-Monat |
Entwicklungsleistungen
Wir bauen jede benutzerdefinierte Anwendung, KI-Fähigkeit oder jeden Agenten, den Sie brauchen. Unser Team erfahrener Entwickler hilft Ihnen, das Maximum aus Assistant Cortex herauszuholen.
Coding Sandbox
Assistant Cortex wurde von Grund auf als selbst-codierende Anwendung gebaut, die eigenständig fortgeschrittene Anwendungen und KI-Fähigkeiten erzeugen kann. Mit unserer Coding-Sandbox-Anwendung geben Sie einen detaillierten Prompt vor, und unser Auto-Coder erstellt die Anwendung oder KI-Fähigkeit nach bestem Können.
Menschliche Entwickler
Für fortgeschrittene Geschäftslogik und die härtesten Probleme braucht es weiterhin einen menschlichen Entwickler. Unser Team arbeitet AI-first und nutzt unseren internen Stack, um Ihre Anforderungen so schnell wie möglich umzusetzen. Kontaktieren Sie uns für ein kostenloses Angebot — eine vom Kunden begonnene Coding-Sandbox-Anwendung fertigzustellen dauert meist nur wenige Stunden.
API-Anbieter
Assistant Cortex unterstützt eine ständig wachsende Zahl von Cloud-Anbietern. Das reicht von großen Sprachmodellen bis zu umfassenden APIs wie denen von HuggingFace, plus Multi-Provider-Routern und Ihren eigenen selbst gehosteten Endpunkten.
HuggingFace API
Zugriff auf die Serverless-Inference-APIs von HF.

Mistral API
Zugriff auf Mistrals Large-, Medium- und Small-LLMs.
Google API
Zugriff auf Googles Gemini-Pro- und Flash-LLMs.

Claude API
Zugriff auf Anthropics Sonnet-, Opus- und Haiku-LLMs.
OpenAI API
Zugriff auf OpenAIs Frontier-LLMs sowie deren Text-to-Speech-, Spracherkennungs- und Text-Embedding-Modelle.
OpenRouter API
Zugriff auf Claude, DeepSeek, Qwen und weitere LLMs über die einheitliche API von OpenRouter.
AWS Bedrock
Zugriff auf Claude, Llama, Nova, Mistral und weitere Foundation-Modelle über AWS Bedrock.
AWS SageMaker
Verbinden Sie Ihre eigenen auf AWS SageMaker bereitgestellten LLM-, Bild- oder Sprach-Endpunkte.
Fal.ai
Zugriff auf Flux-, Qwen- und Wan-Modelle auf Fal.ai für Bild-, Audio- und Videogenerierung.
Bring Your Own Key
Sie haben bereits Konten bei den oben genannten Anbietern? Verbinden Sie Ihre eigenen API-Schlüssel mit Ihrer Assistant-Cortex-Instanz und lassen Sie die Inferenz darüber laufen — Sie zahlen direkt beim Anbieter zu dessen Konditionen statt unserer nutzungsabhängigen Modellpreise. Der einfachste Weg, bei hochvolumigen Workloads Inferenzkosten zu sparen. Kontaktieren Sie den Vertrieb für Details.
Ihre Schlüssel, deren Preise
Hinterlegen Sie eigene Schlüssel für Anbieter wie OpenAI, Anthropic, Google, Mistral, OpenRouter und Fal.ai. Aufrufe mit Ihren Schlüsseln rechnet der Anbieter direkt ab — Sie zahlen exakt dessen Preise.
Frei kombinierbar
Bringen Sie einen Schlüssel für einen Anbieter mit und bleiben Sie für alles andere bei Pay-as-you-go. Der Rest Ihrer Abrechnung — Seats, Telefonnummern, Speicher und lokal gehostete Modelle — funktioniert exakt gleich.
Enterprise-Bereitstellung
Die Assistant-Cortex-Codebasis kann lizenziert werden, um vollständig maßgeschneiderte SaaS-Produkte unter Ihrer eigenen Marke zu bauen. Sie erhalten die komplette Plattform — Benutzerverwaltung, Abrechnung, das KI-Framework, den Anwendungsmarktplatz und die Coding-Tools — als Fundament, sodass Ihr Team in Wochen ein ausgereiftes Produkt ausliefert, statt die schwierigsten Teile selbst zu bauen. Lizenzierung, Hosting und Entwicklungsunterstützung stimmen wir auf Ihr Projekt ab; kontaktieren Sie den Vertrieb, um zu besprechen, was Sie bauen möchten.
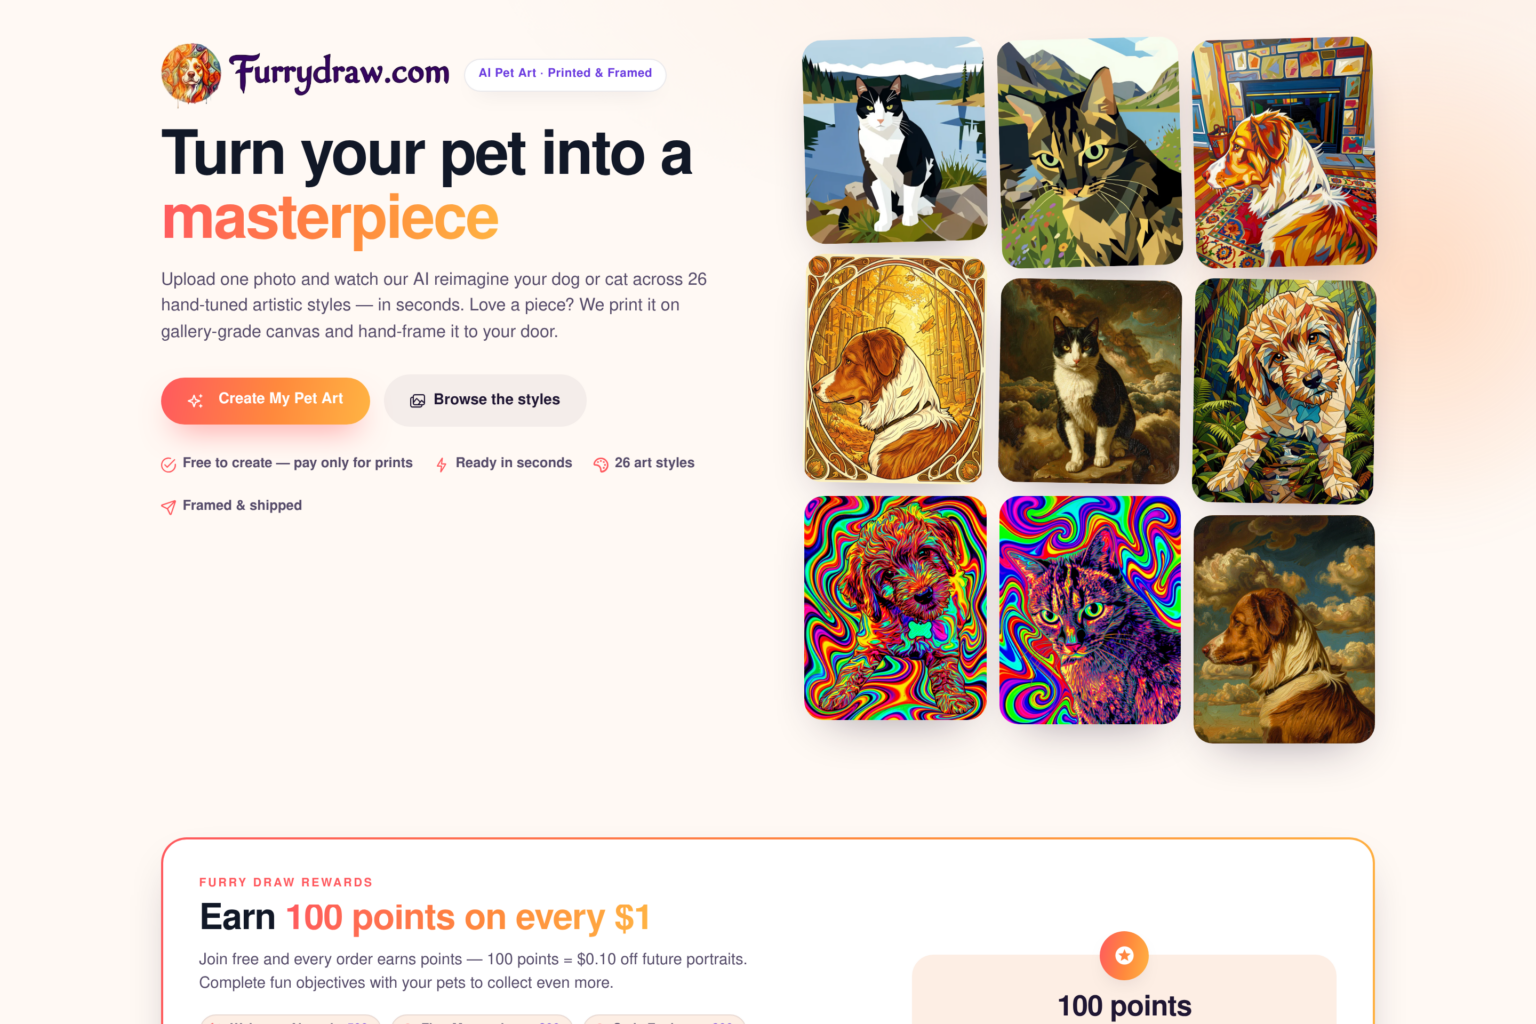
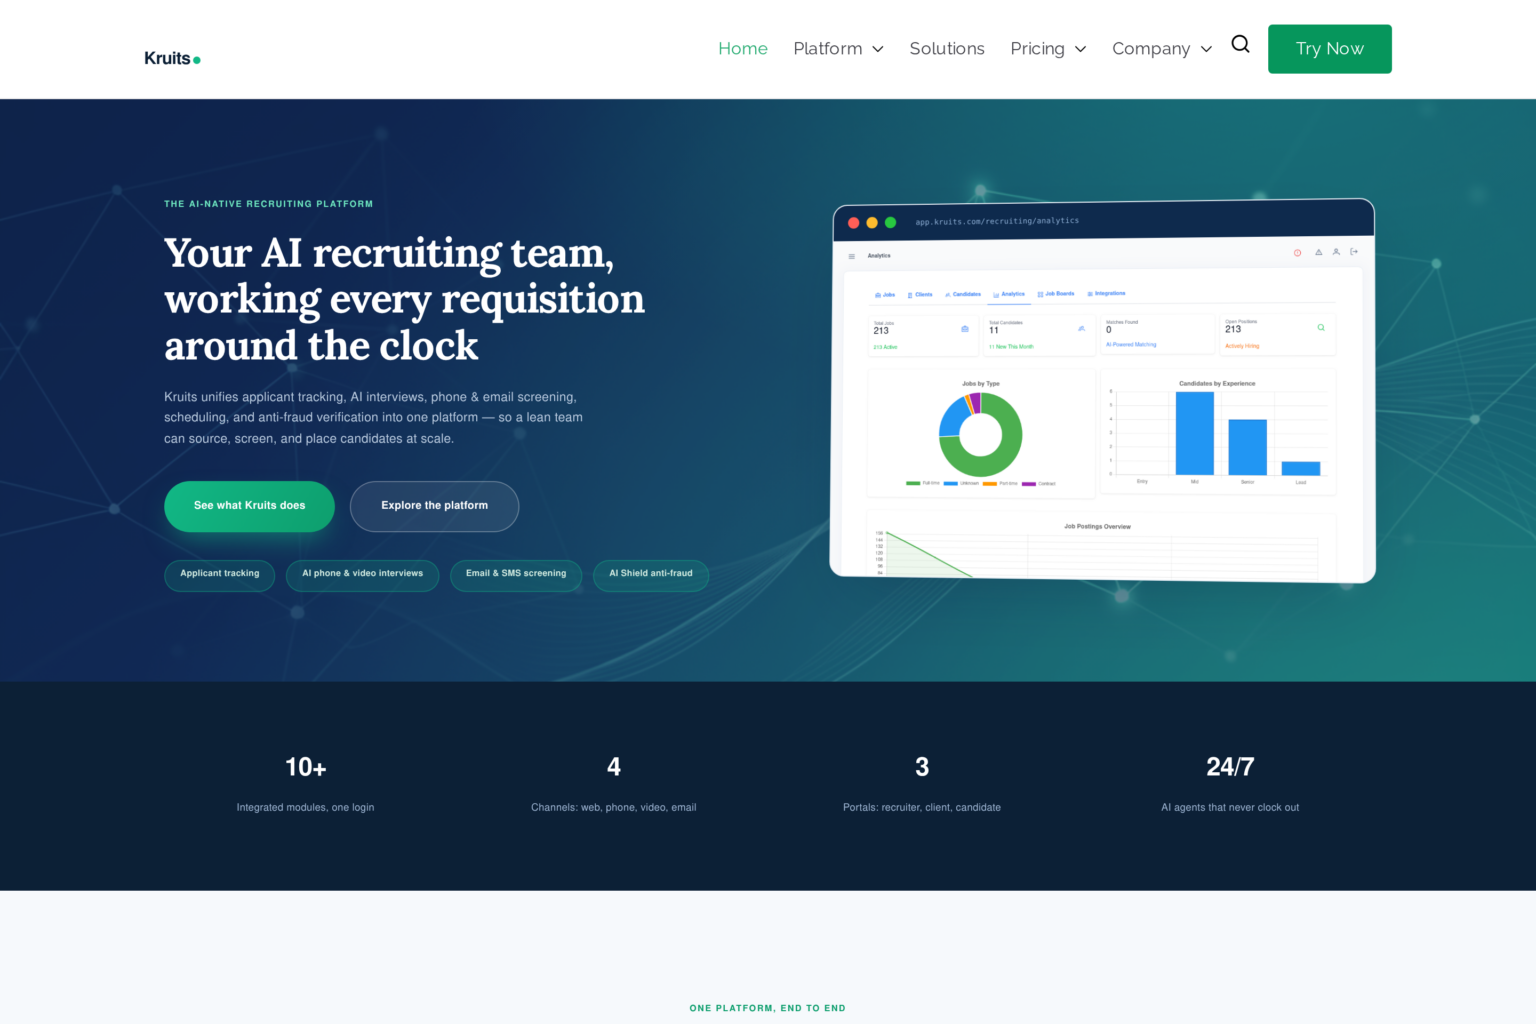
Beide untenstehenden Produkte sind live laufende, maßgeschneiderte SaaS-Builds auf der Assistant-Cortex-Plattform.
Bereit loszulegen?
Jede Assistant-Cortex-Instanz kommt mit 20 $ Startguthaben zum Ausprobieren.