Ein Chat-Fenster, das Mathematik, Code und Diagramme so darstellt, wie sie gelesen werden sollen
Die Chat-Oberfläche ist das, wovor jeder Benutzer tatsächlich sitzt: gestreamte Antworten mit live gerendertem LaTeX und syntaxhervorgehobenem Code, Stop-and-Resume-Generierung, die sich nie wiederholt, Modell-Overrides pro Konversation und ein vollständiger Verlauf jeder Konversation — durchsuchbar und nach Tags organisiert.
Es ist dieselbe Oberfläche für jeden Agenten der Instanz — kein separates Chat-Produkt, das integriert werden müsste.
Der Anfang: einen Agenten auswählen
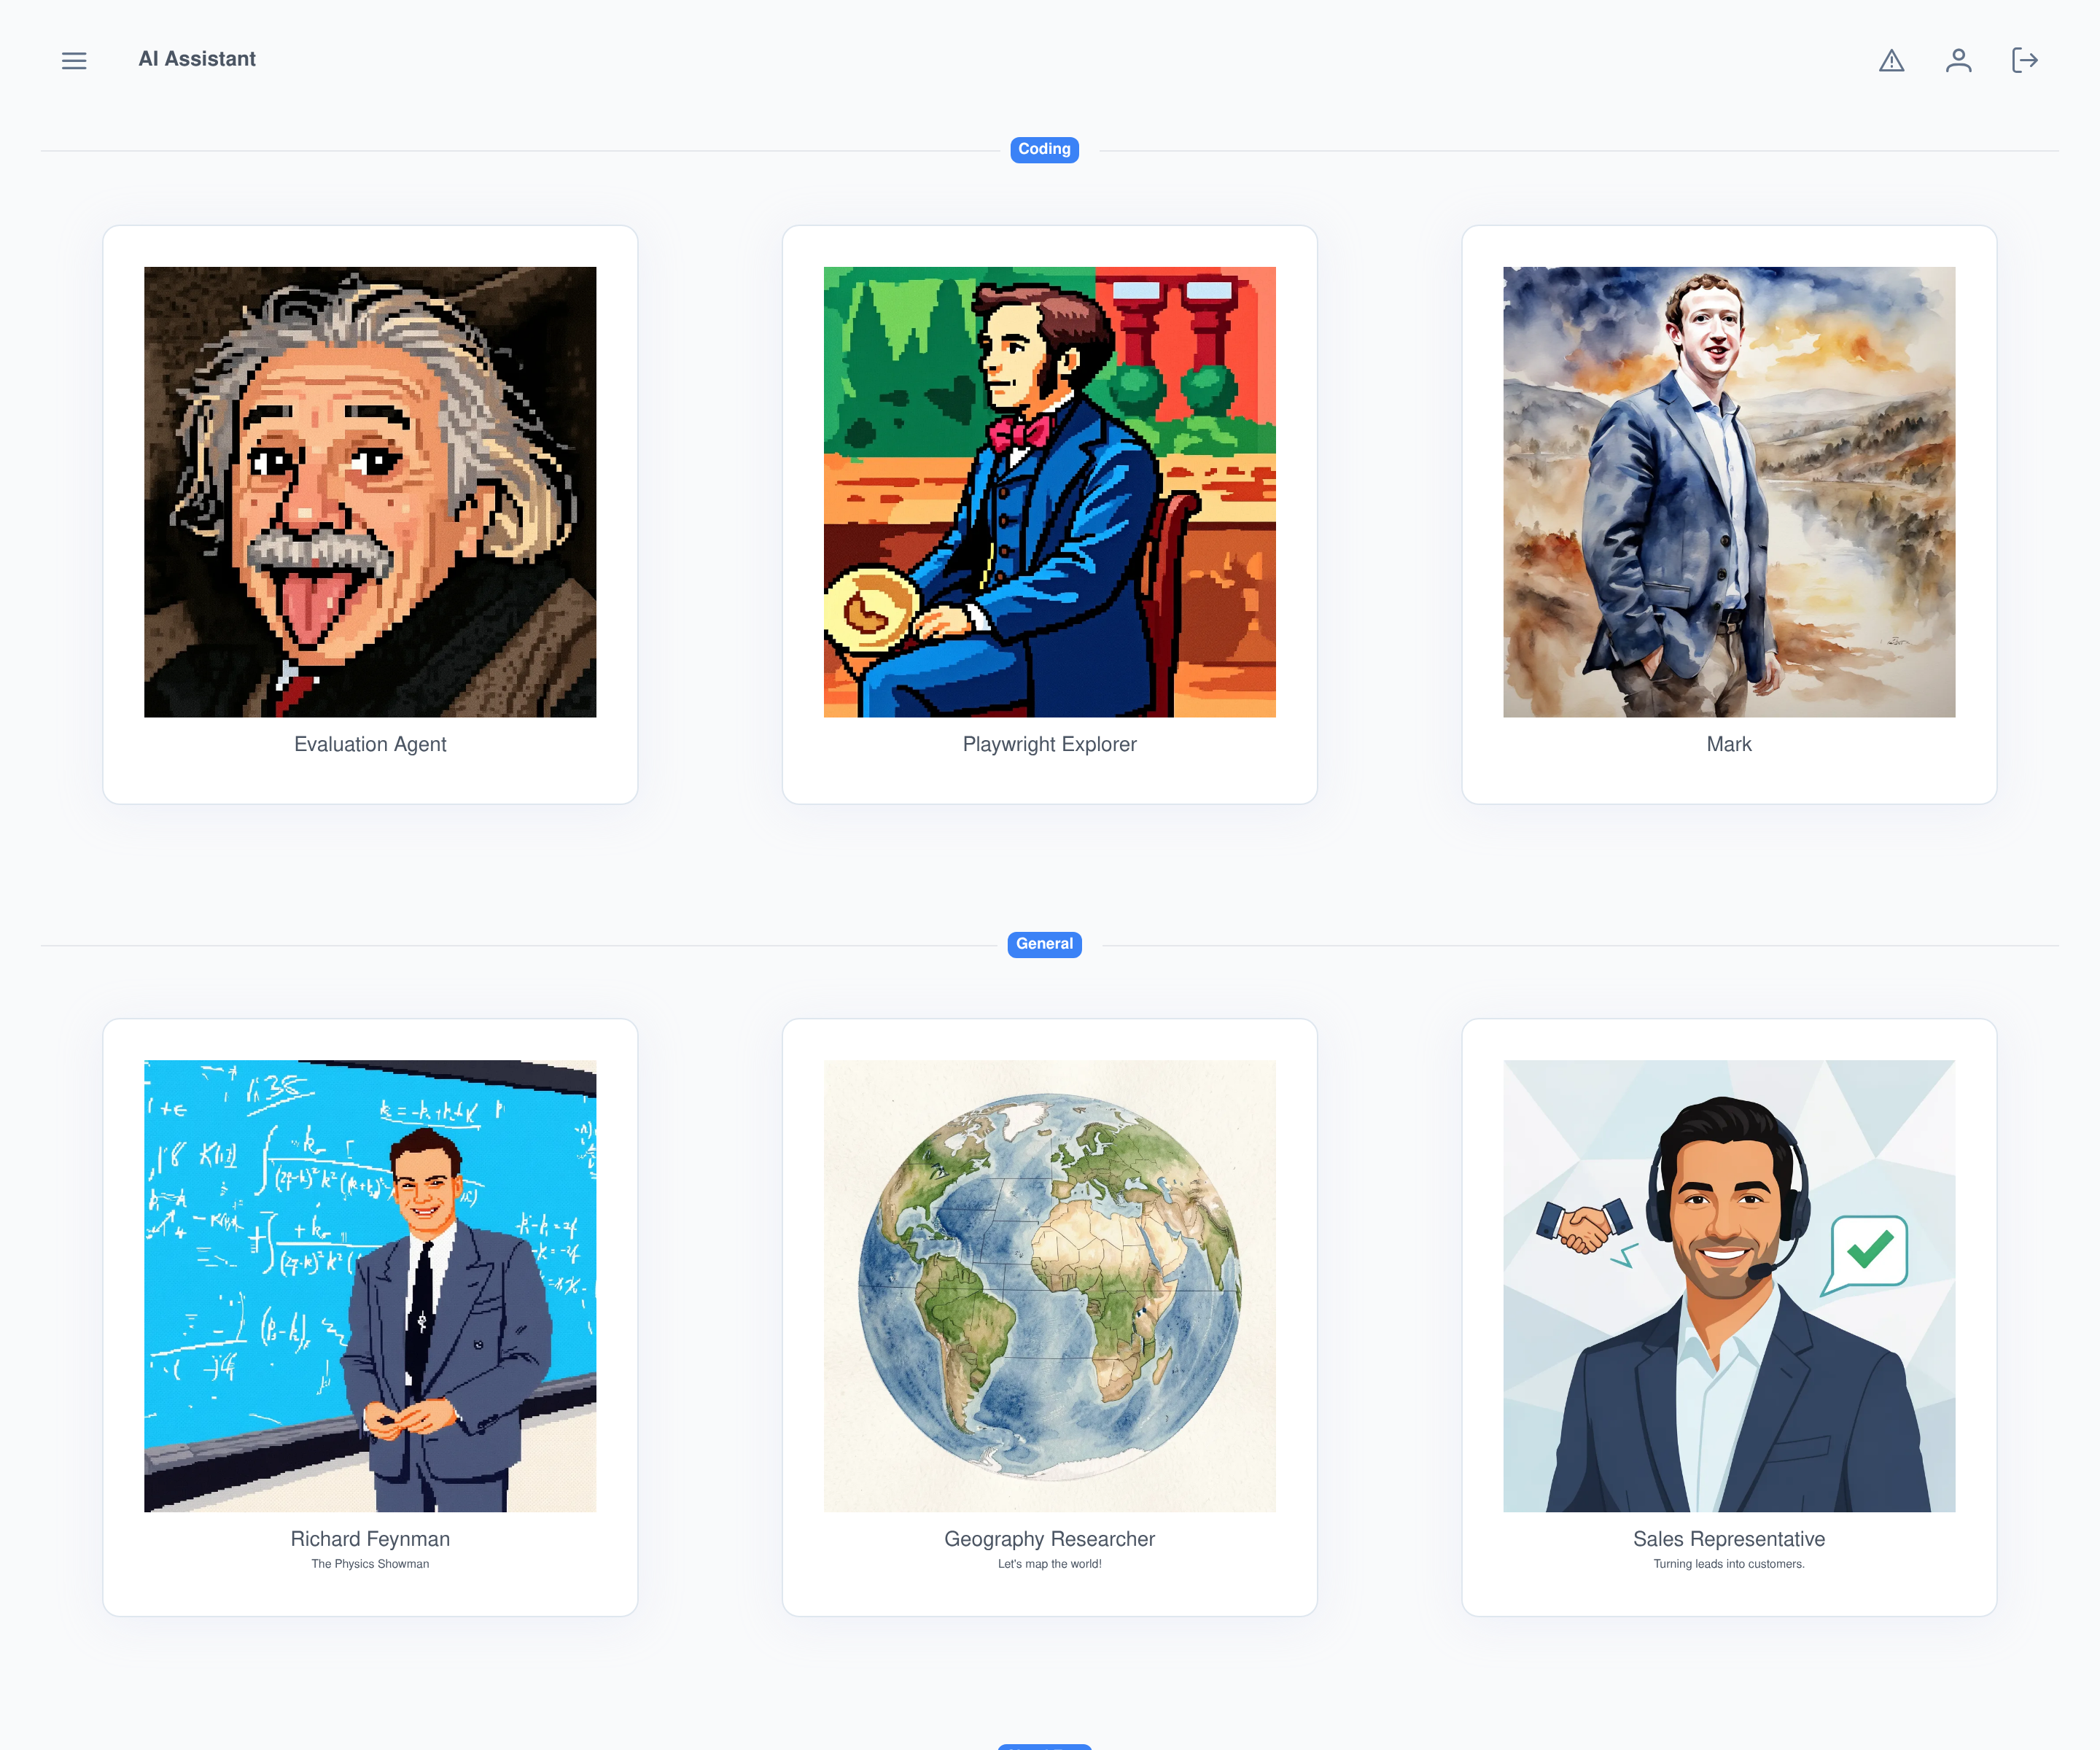
Jede Konversation beginnt auf derselben Auswahlseite: Agenten nach Kategorien gruppiert, jeder nur einen Klick von einem Live-Chat entfernt. Es gibt keinen separaten „Chat starten“-Ablauf zu konfigurieren — hier landen und einen Agenten öffnen ist bereits der gesamte Workflow.
Gebaut für echte Konversationen, nicht für Demos
1. Fragen Sie irgendetwas
Tippen, einfügen, eine Datei hineinziehen oder sprechen — dasselbe Eingabefeld beherrscht alle vier Wege.
2. Eine echte Antwort streamt herein
Mathematik wird gesetzt, Code hervorgehoben, Diagramme gerendert — noch während die Tokens eintreffen.
3. Stoppen, bearbeiten oder zurückspulen
Generierung unterbrechen, einen früheren Beitrag bearbeiten oder eine neue Variante abzweigen — nichts ist jemals festgeschrieben.
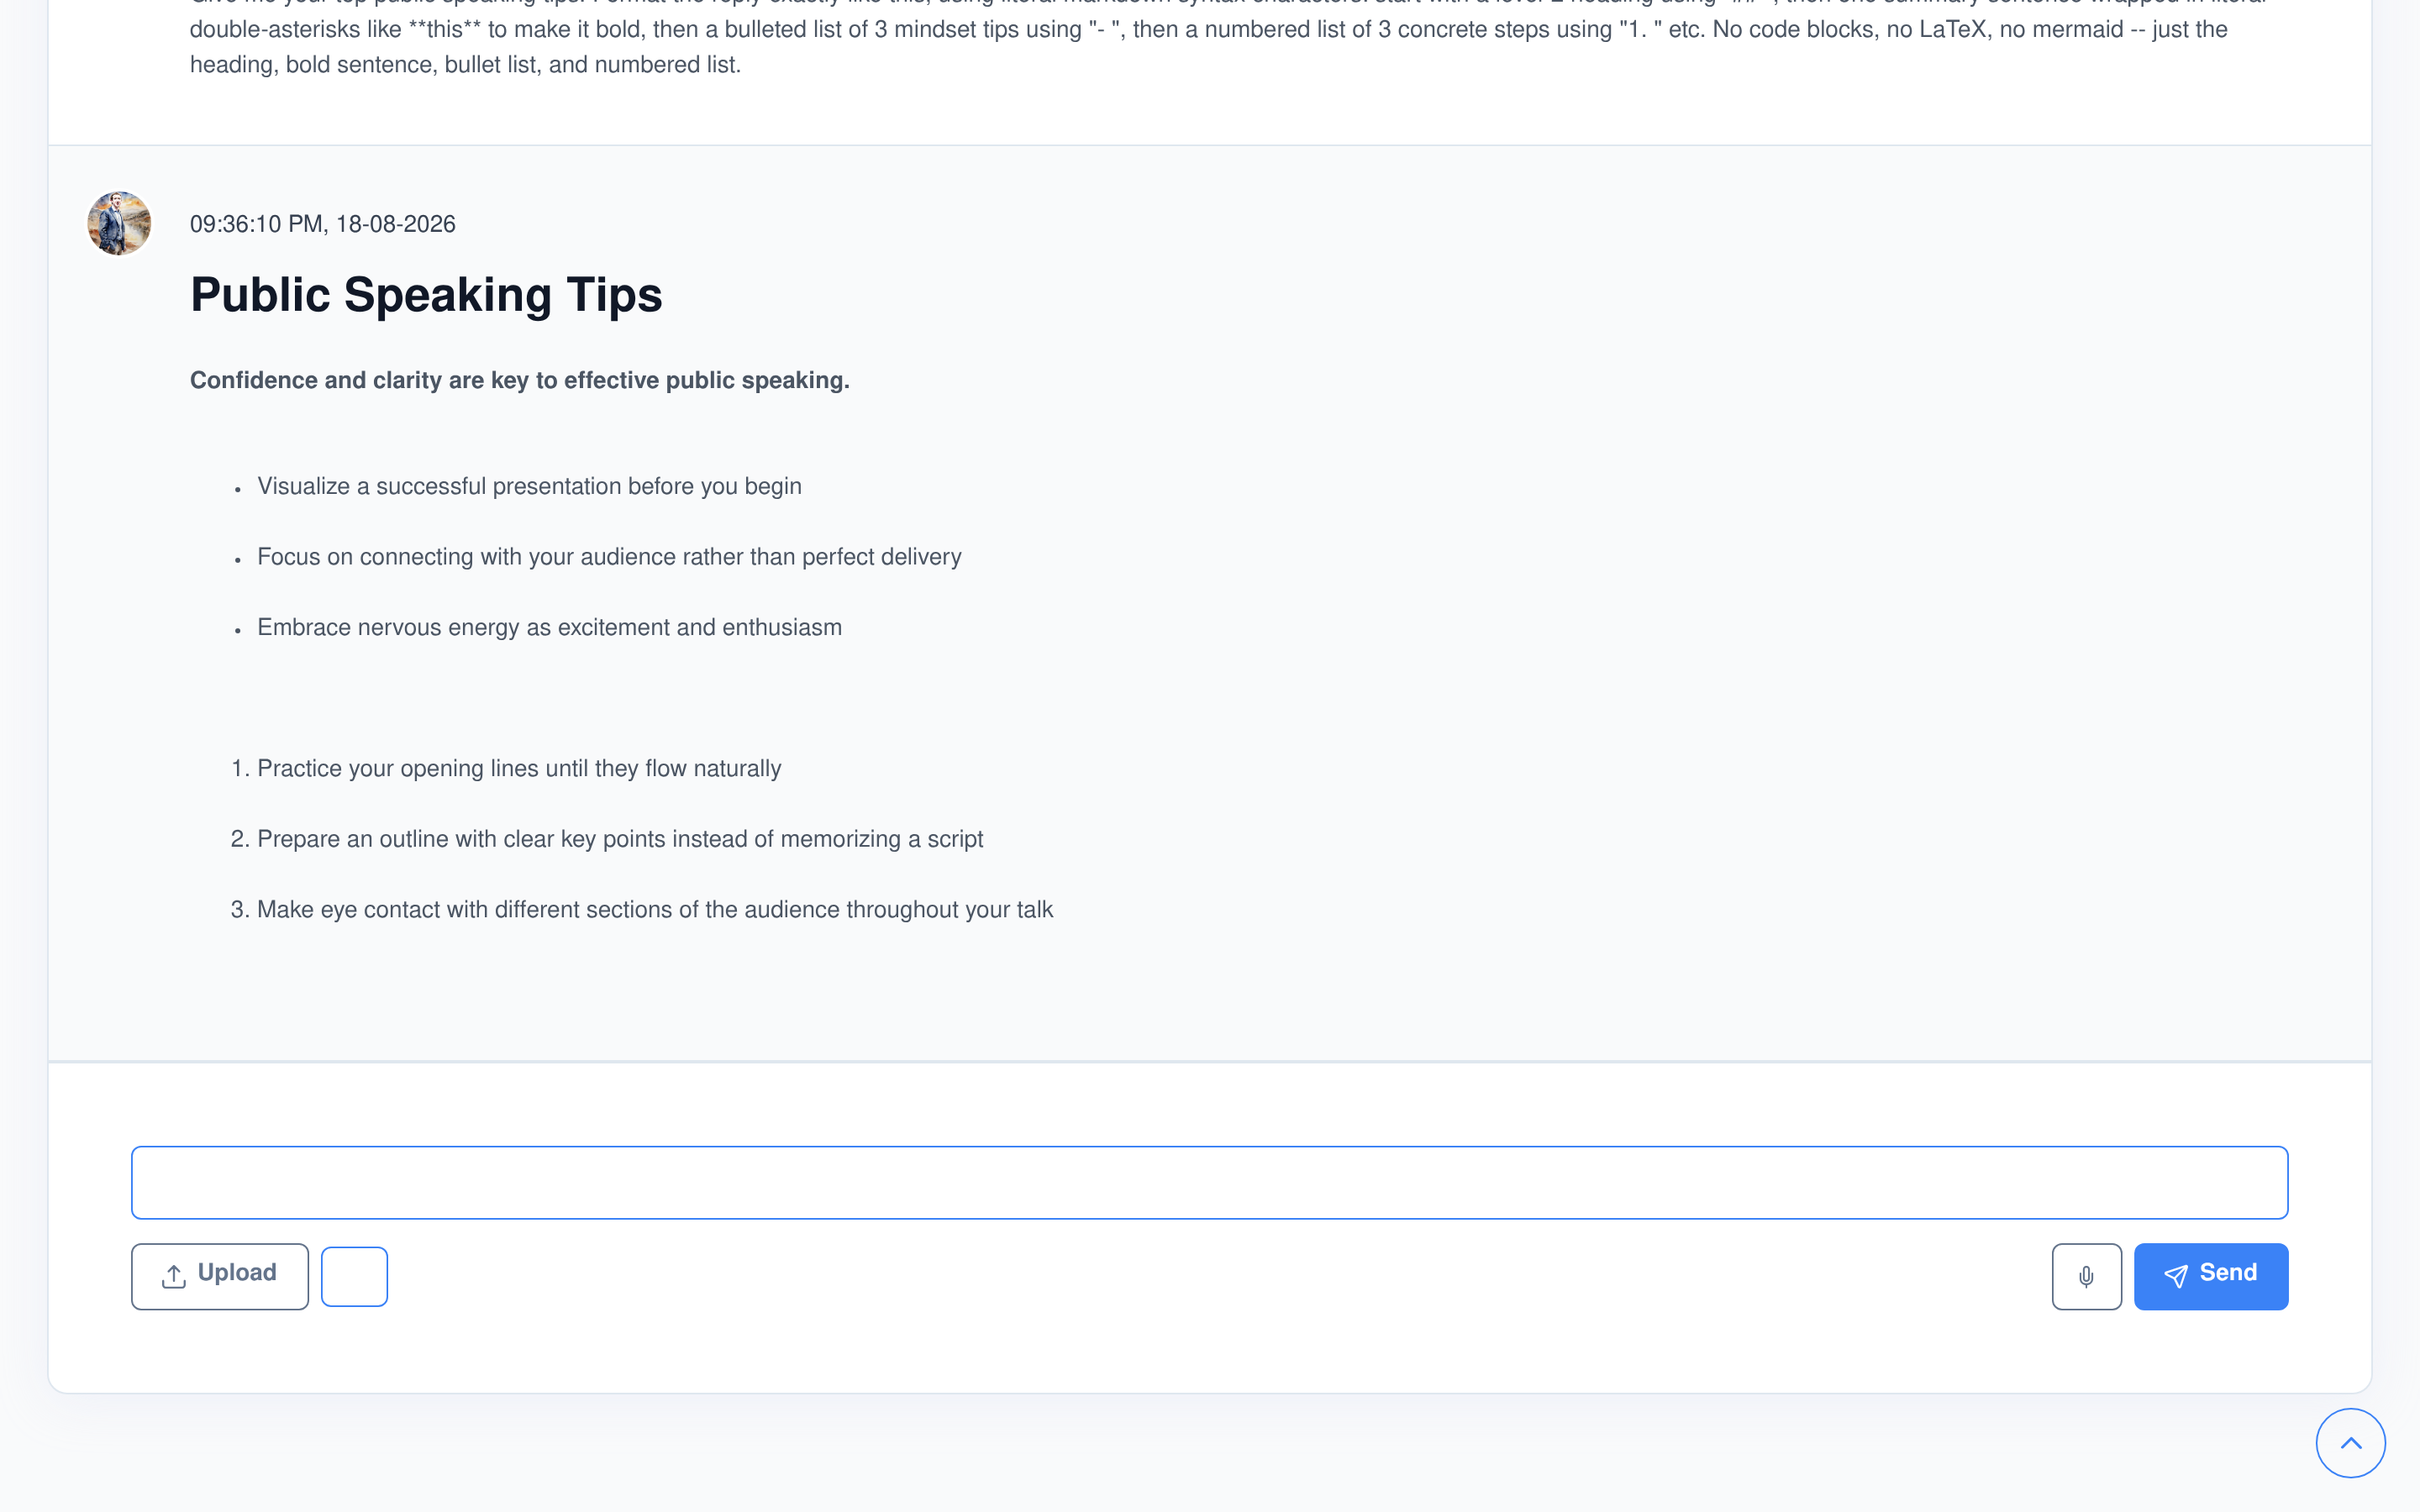
Jede Antwort sieht aus wie für ein Dokument geschrieben, nicht für ein Textfeld
Die meisten Chat-Widgets zeigen das rohe Markdown des Modells. Diese Oberfläche parst es bereits, während die Antwort hereinstreamt.
Mathematik und Diagramme
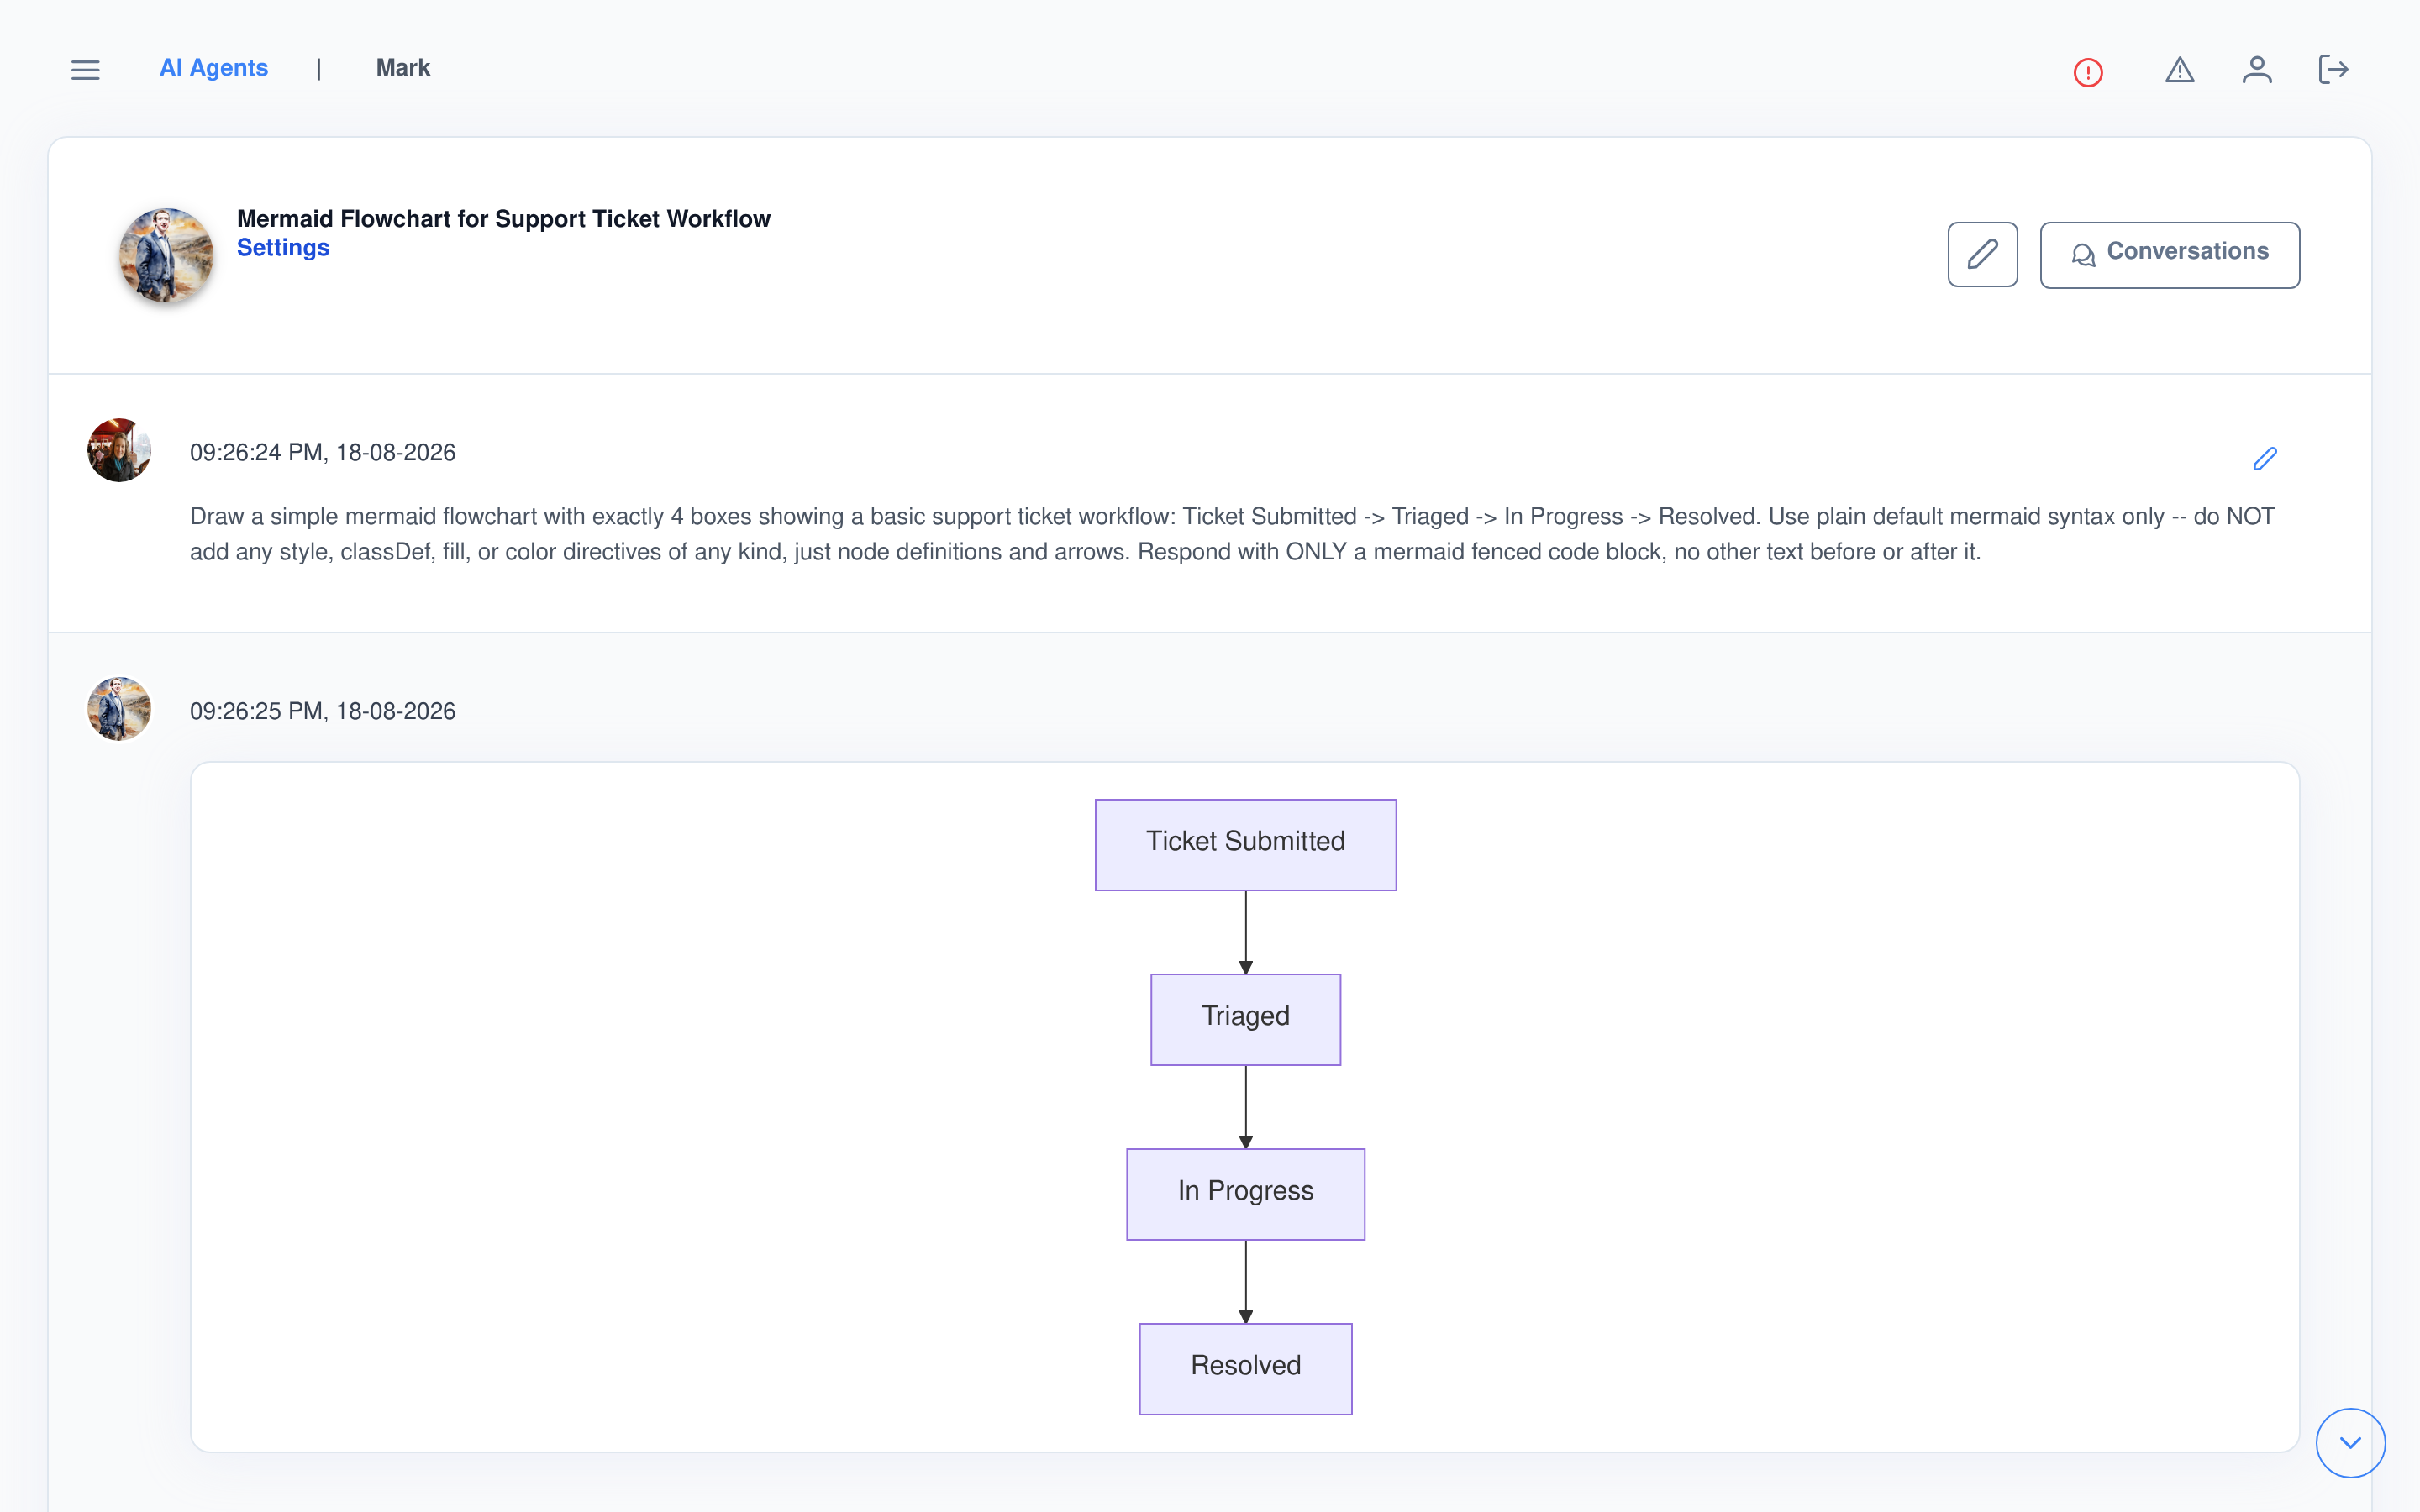
- LaTeX wird automatisch erkannt und live mit MathJax gesetzt — kein Schalter, den man erst suchen müsste.
- Ein eingezäunter
mermaid-Block wird als echtes Diagramm gerendert, nicht als roher Code.
Code
- Syntaxhervorhebung pro Block, mit ausgewiesener Sprache und einem Ein-Klick-Kopieren-Button.
- Generierte und hochgeladene Dateien — Bilder, Audio, Video, sogar 3D-Modelle — werden inline gerendert, nicht als bloßer Link.
Kein Screenshot von Markdown — eine tatsächlich gesetzte Gleichung
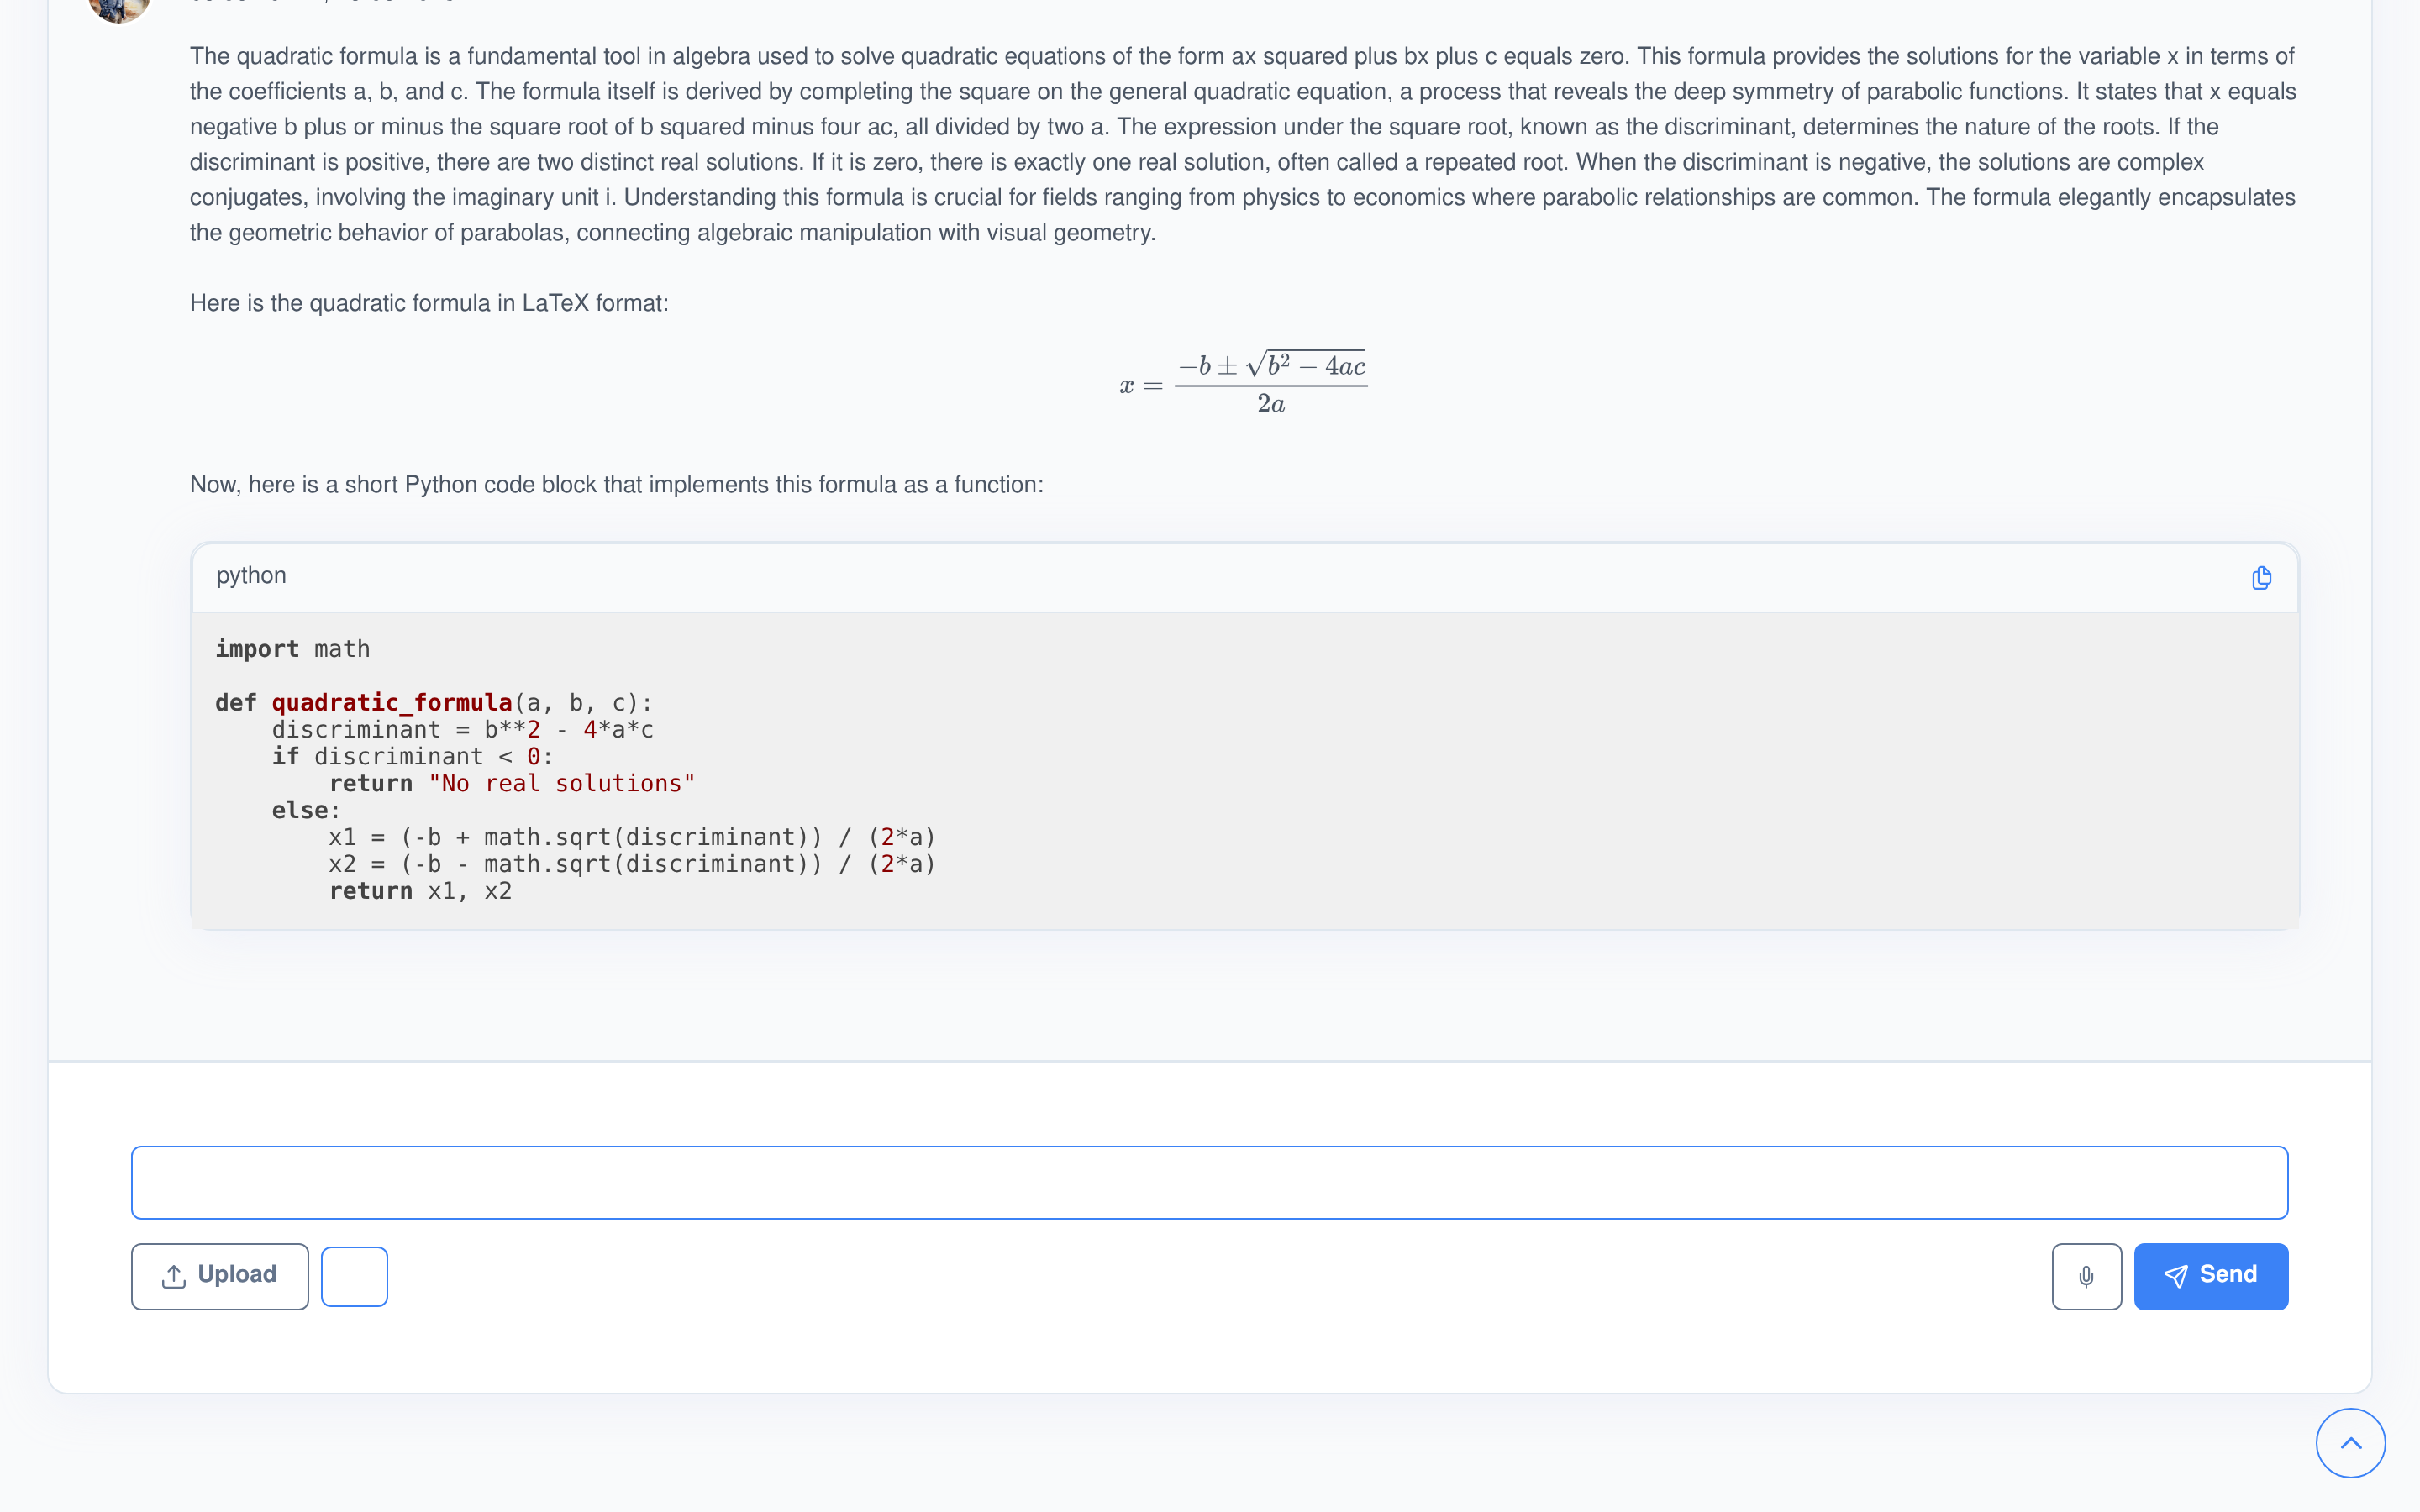
Live angefragt: die Mitternachtsformel in LaTeX schreiben und anschließend als kurze Python-Funktion implementieren. Die Antwort unten ist unbearbeitet — eine echte, von MathJax gesetzte Gleichung neben einem echten syntaxhervorgehobenen Code-Block mit eigenem Kopieren-Button.
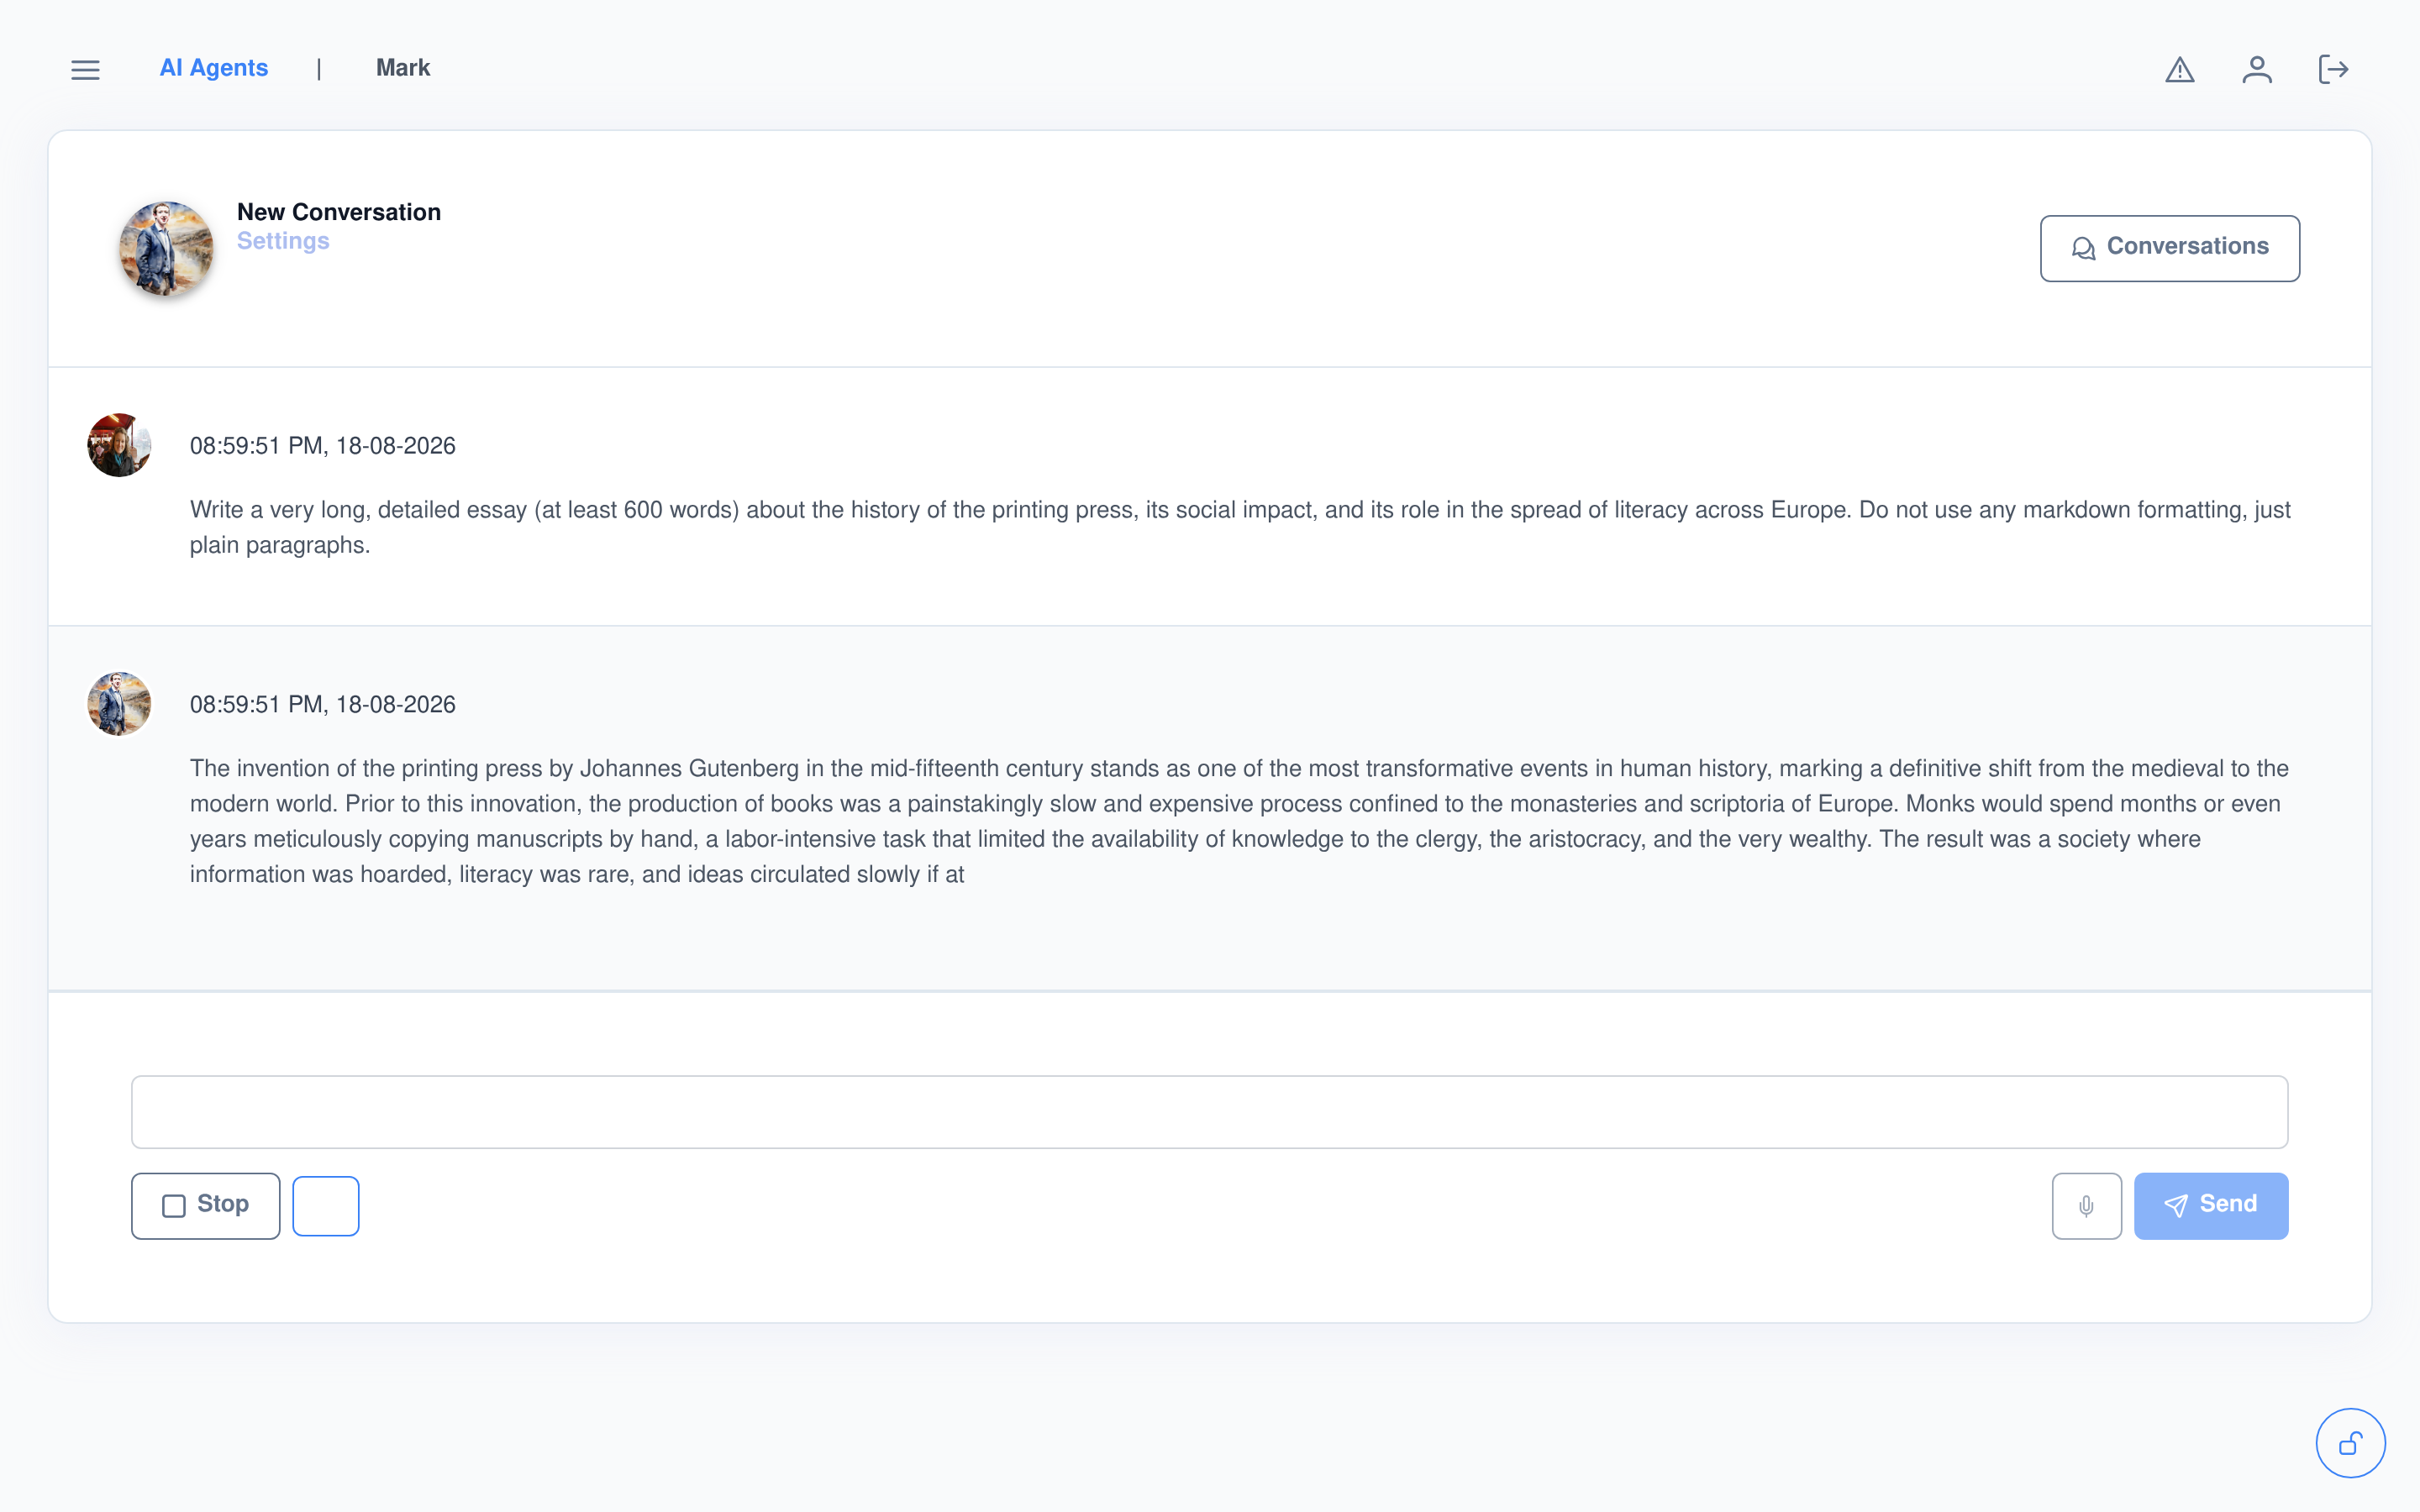
Mitten im Satz stoppen. Mitten im Satz weitermachen.
Live um einen Aufsatz mit 600 Wörtern gebeten, dann mittendrin mit Stop unterbrochen. Was zurückkam, war kein Neustart — „Continue Generation“ setzte exakt bei dem Wort an, bei dem es aufgehört hatte, und führte den Gedanken natürlich zu Ende, ohne Wiederholung, ohne Auslassung.
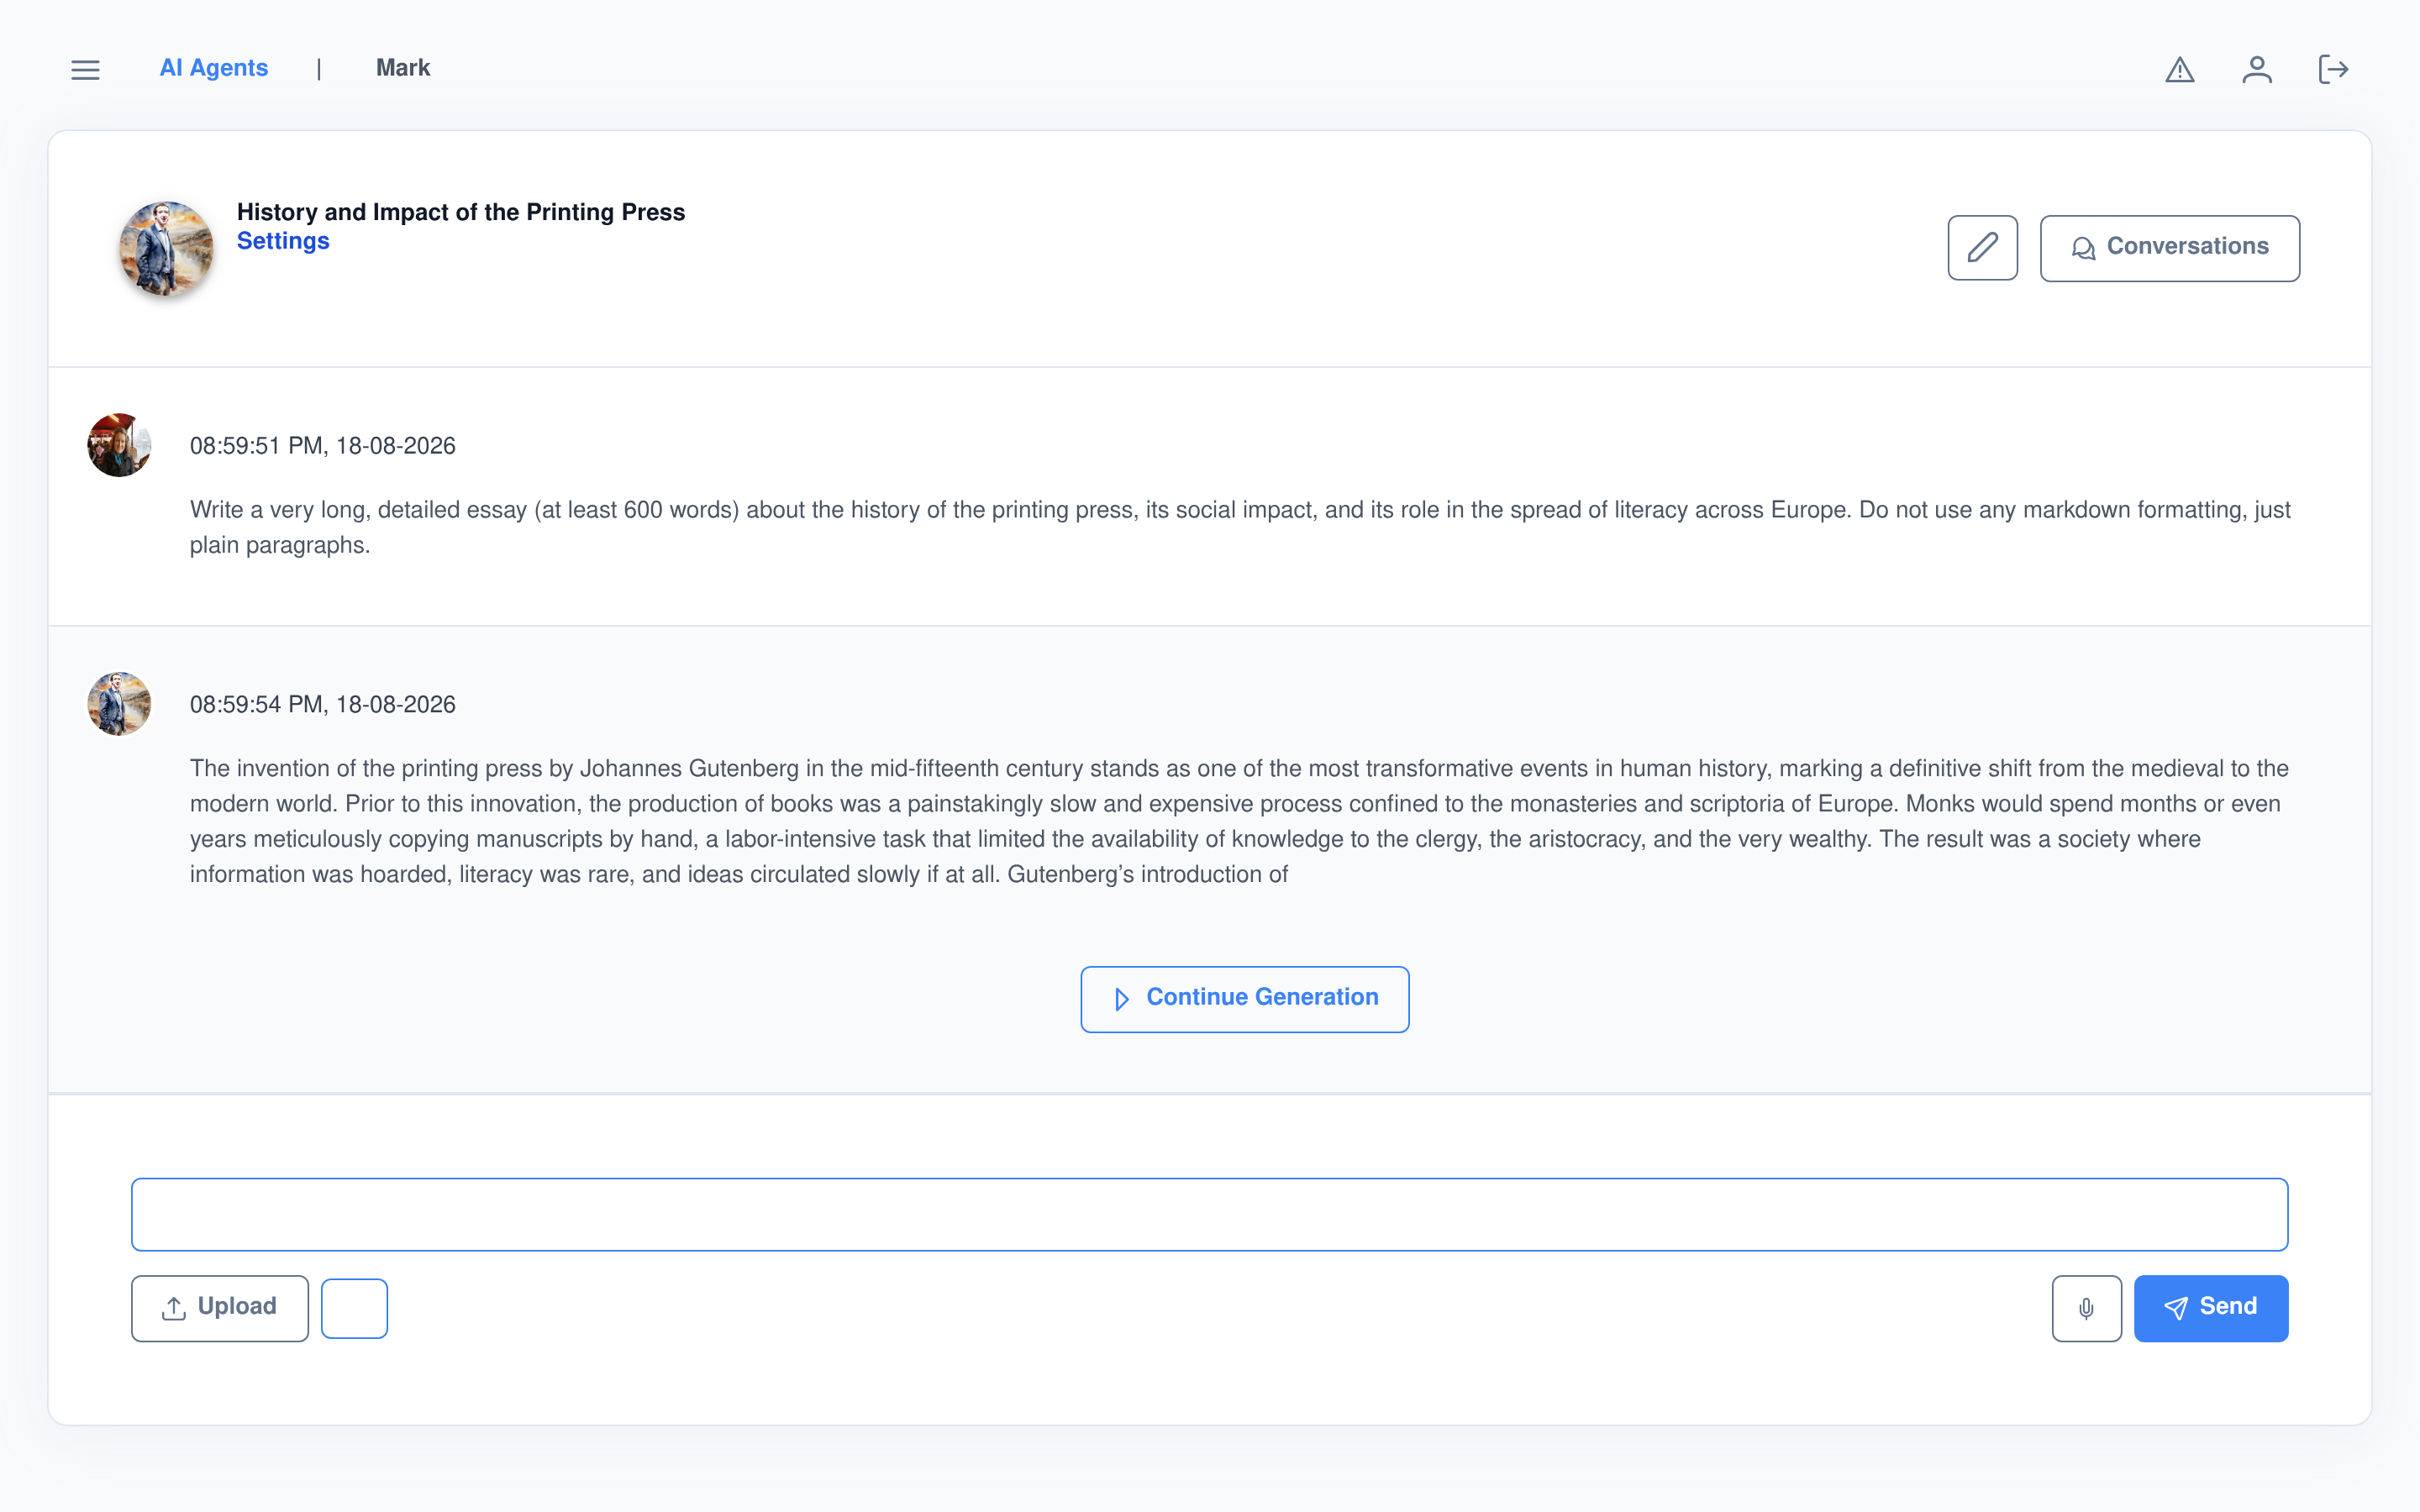
Einen Klick später: fertiggestellt, nicht neu gestartet
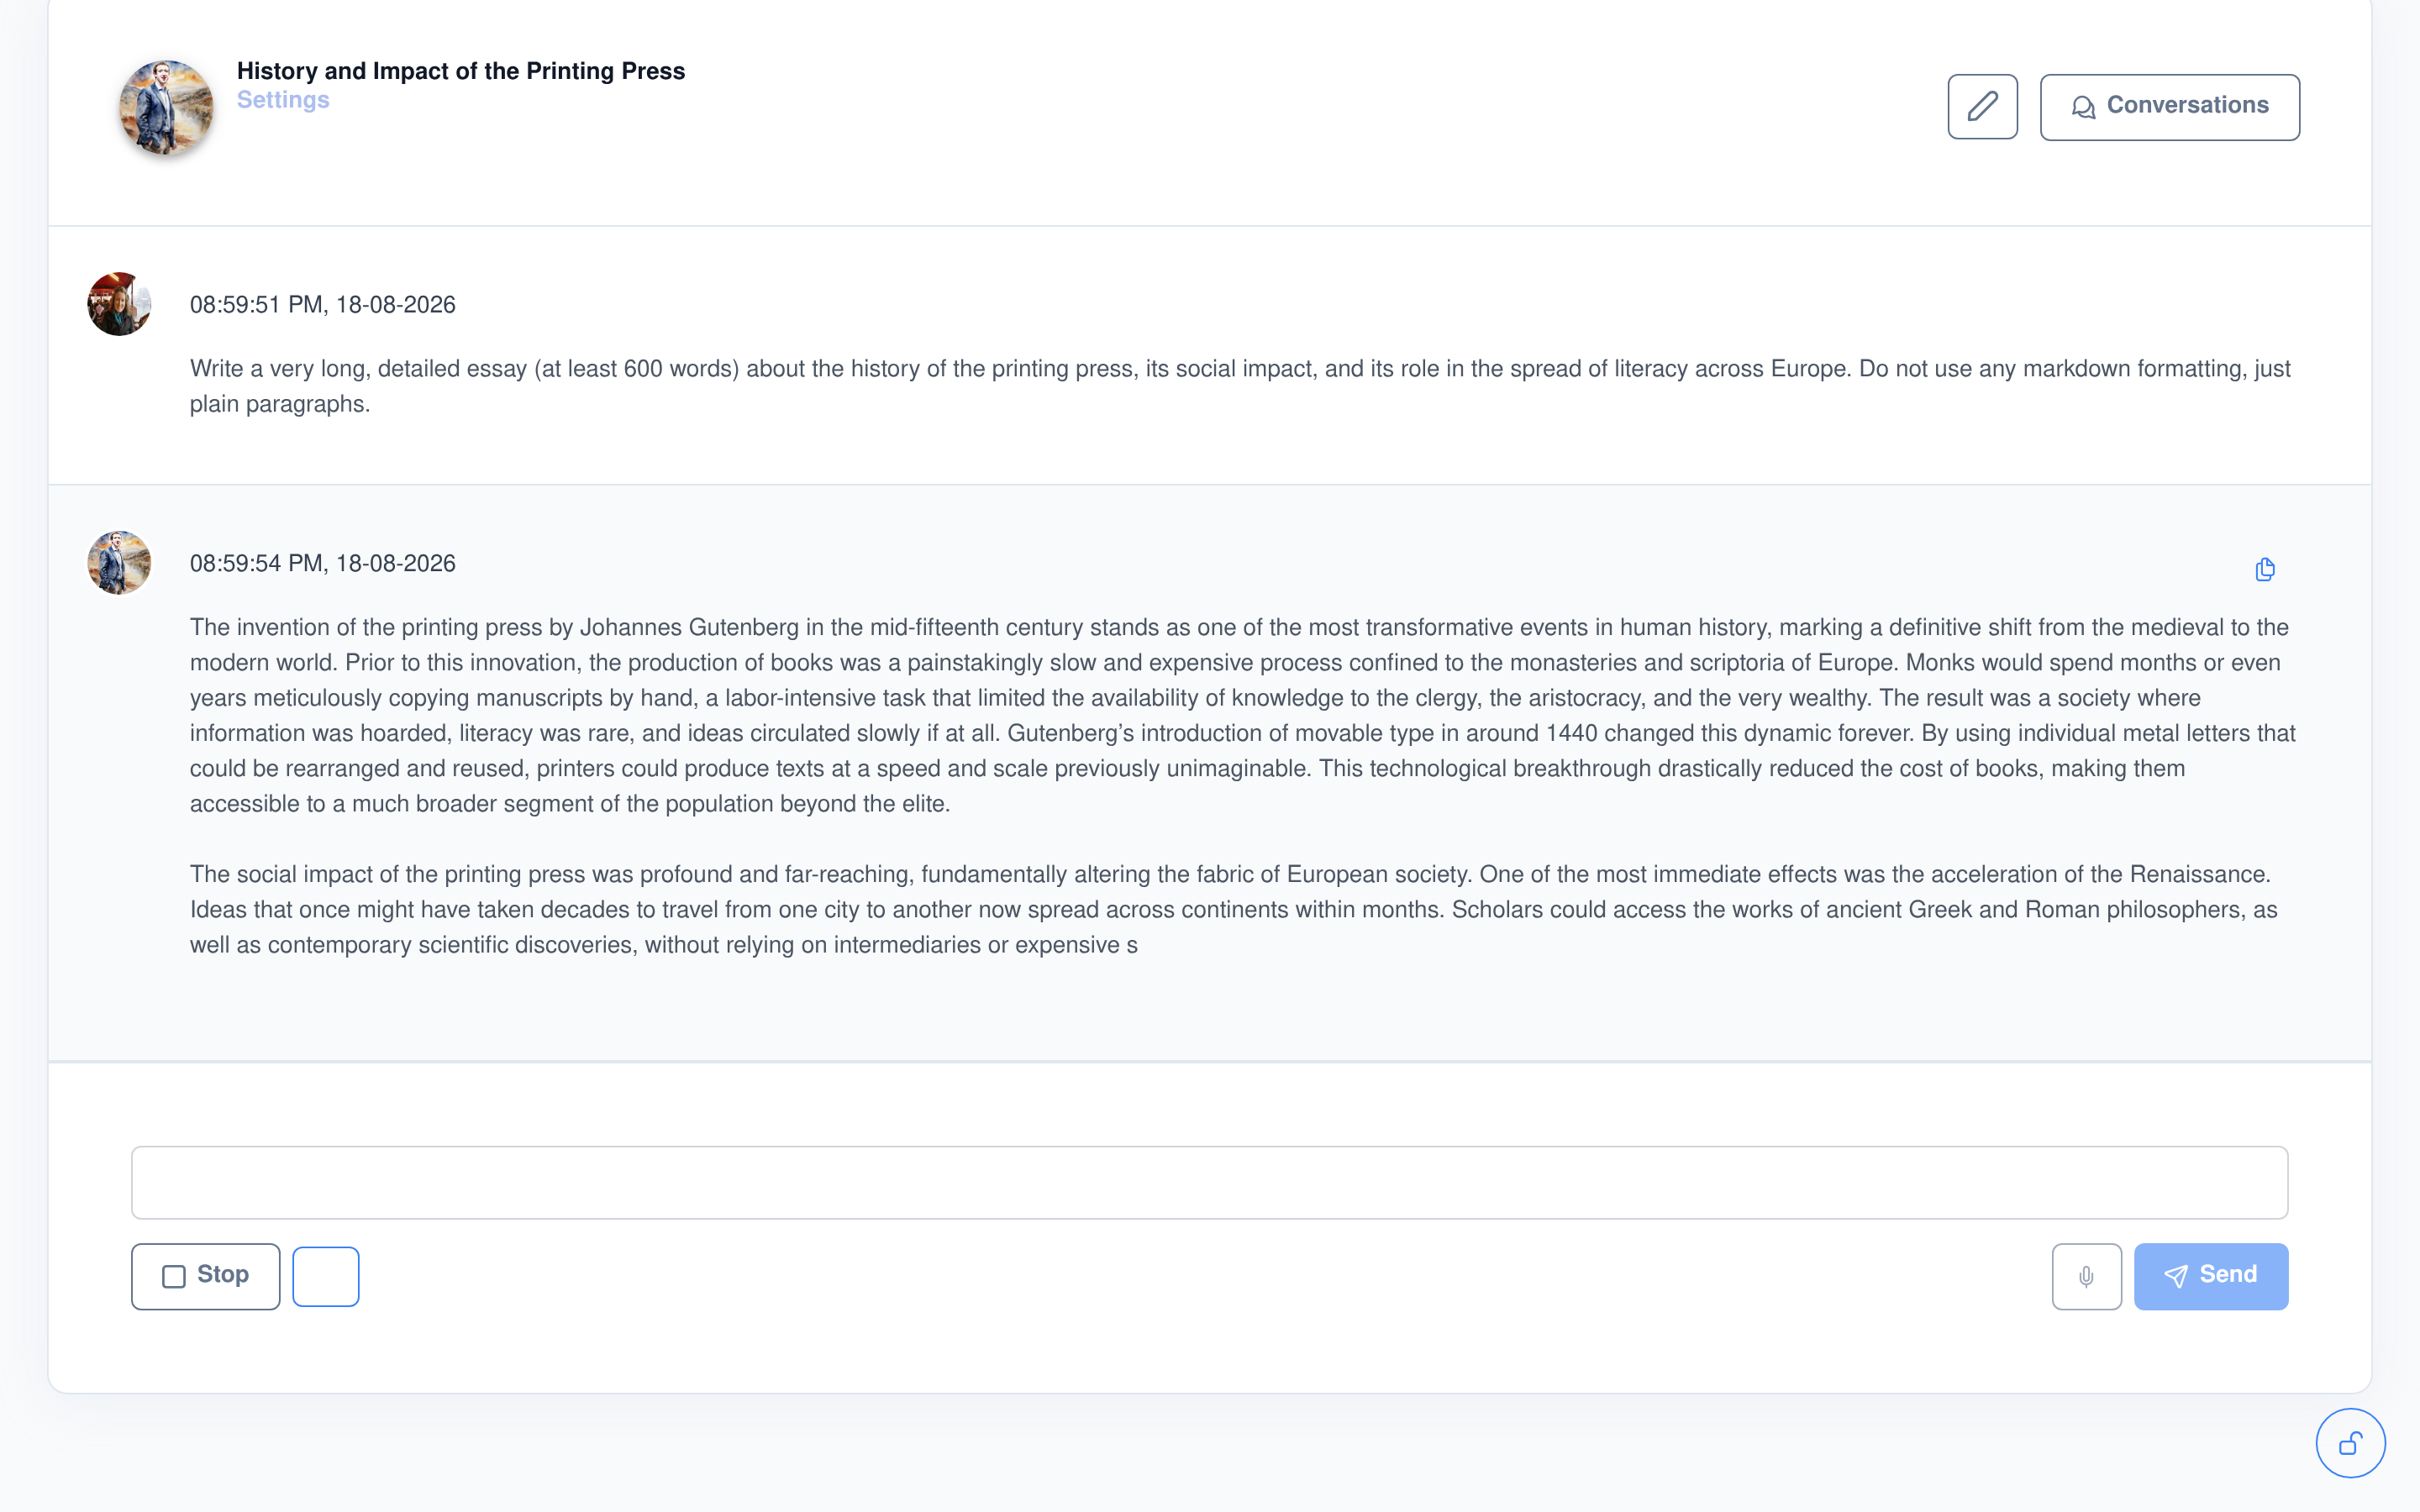
Genau sehen, was es getan hat — und was es dabei dachte
Ausgeführte KI-Fähigkeiten
- Jeder Tool-Aufruf des Agenten erscheint in einem aufklappbaren Panel an der jeweiligen Nachricht — mit dem Icon des Tools, seinen Parametern und seiner Antwort, die während der Ausführung live mit Fortschrittsanzeige hereinstreamt.
- Bestimmte Aufrufe halten zuerst an und fragen nach: eine Inline-Abfrage „Execute AI Ability“ lässt Sie den Aufruf ausführen oder das Modell ohne ihn antworten — bevor irgendetwas ausgeführt wird.
Gedanken und Quellenangaben
- Bei einem Thinking-Modell erscheint die Argumentation in einem eigenen aufklappbaren „Thought“-Panel — getrennt von der endgültigen Antwort, nicht mit ihr vermischt.
- Eine belegte Antwort trägt einen ausklappbaren Citations-Abschnitt, der das Quelldokument und den exakten Auszug benennt, aus dem sie schöpft.
Jede Konversation: aufbewahrt und durchsuchbar
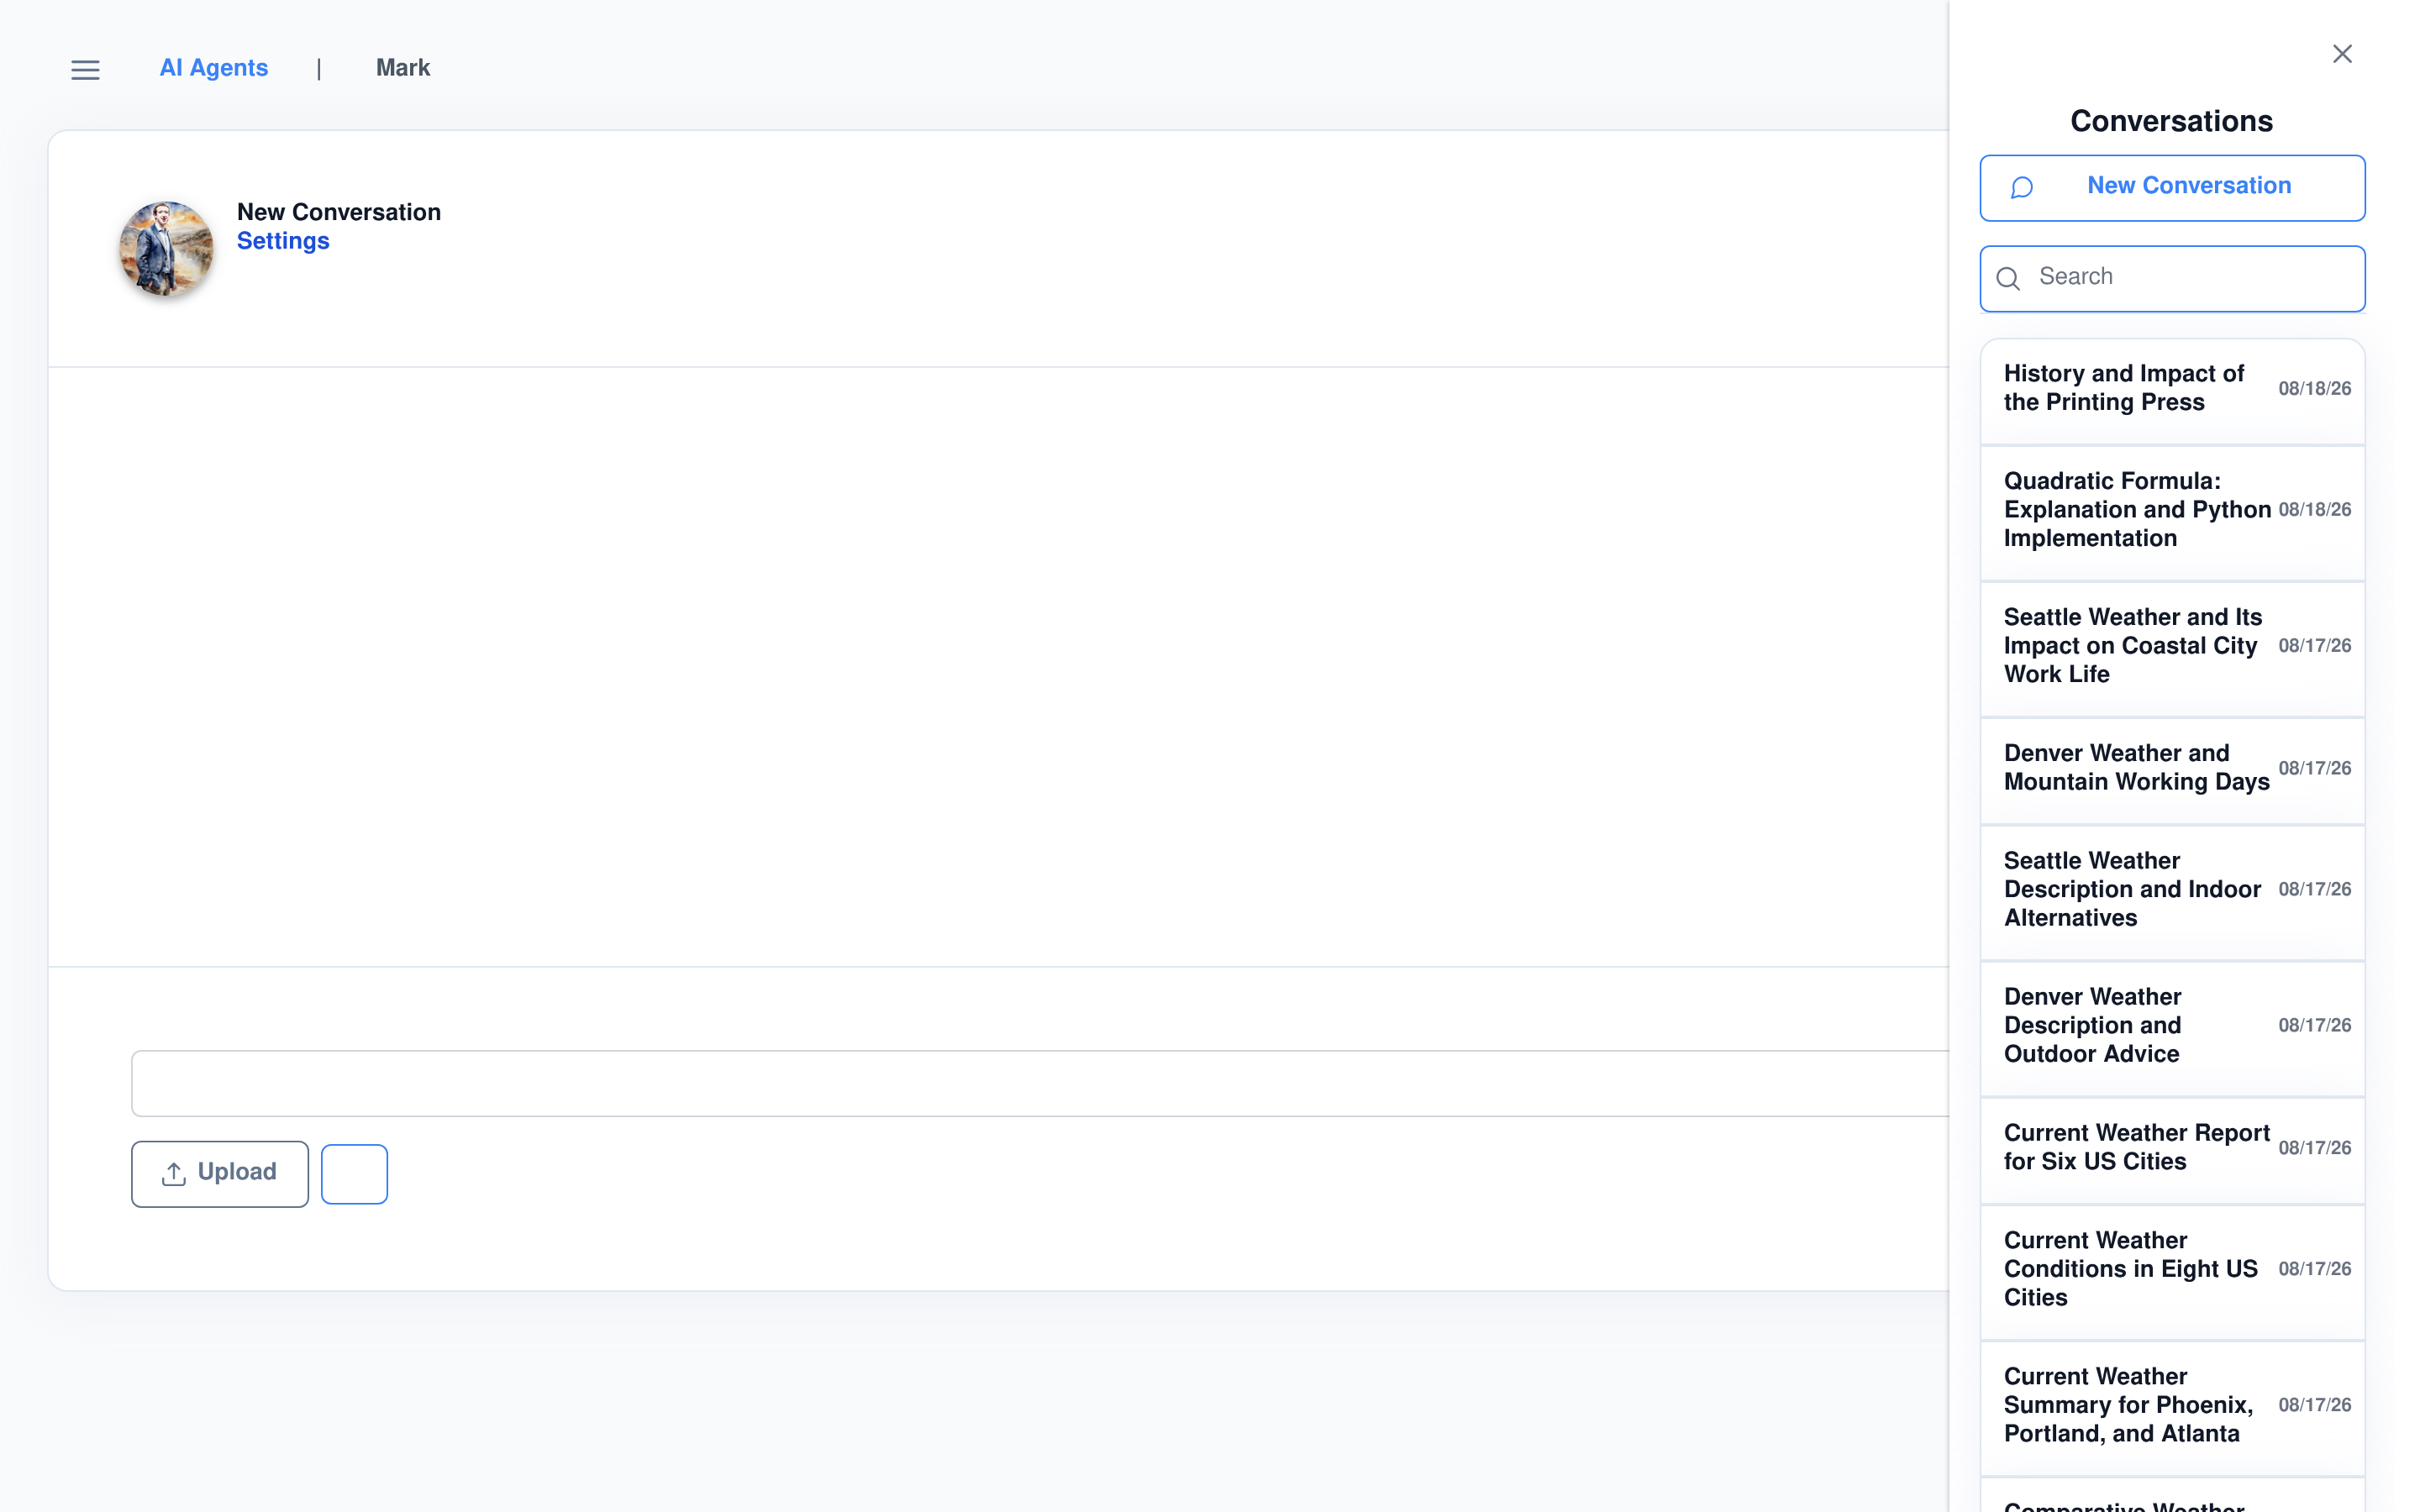
Die Seitenleiste listet jede Konversation mit einer Live-Suche, gruppiert nach Tags mit aufklappbarer Kopfzeile pro Gruppe, plus einem Sammelbereich für alles ohne Tag. Favoriten sind mit einem Stern markiert und schwimmen nach oben.
- Abgebildet ist der echte Verlauf eines echten Kontos — Wetterabfragen, Code-Fragen und die Demo-Konversationen dieser Seite — nichts ist gestellt.
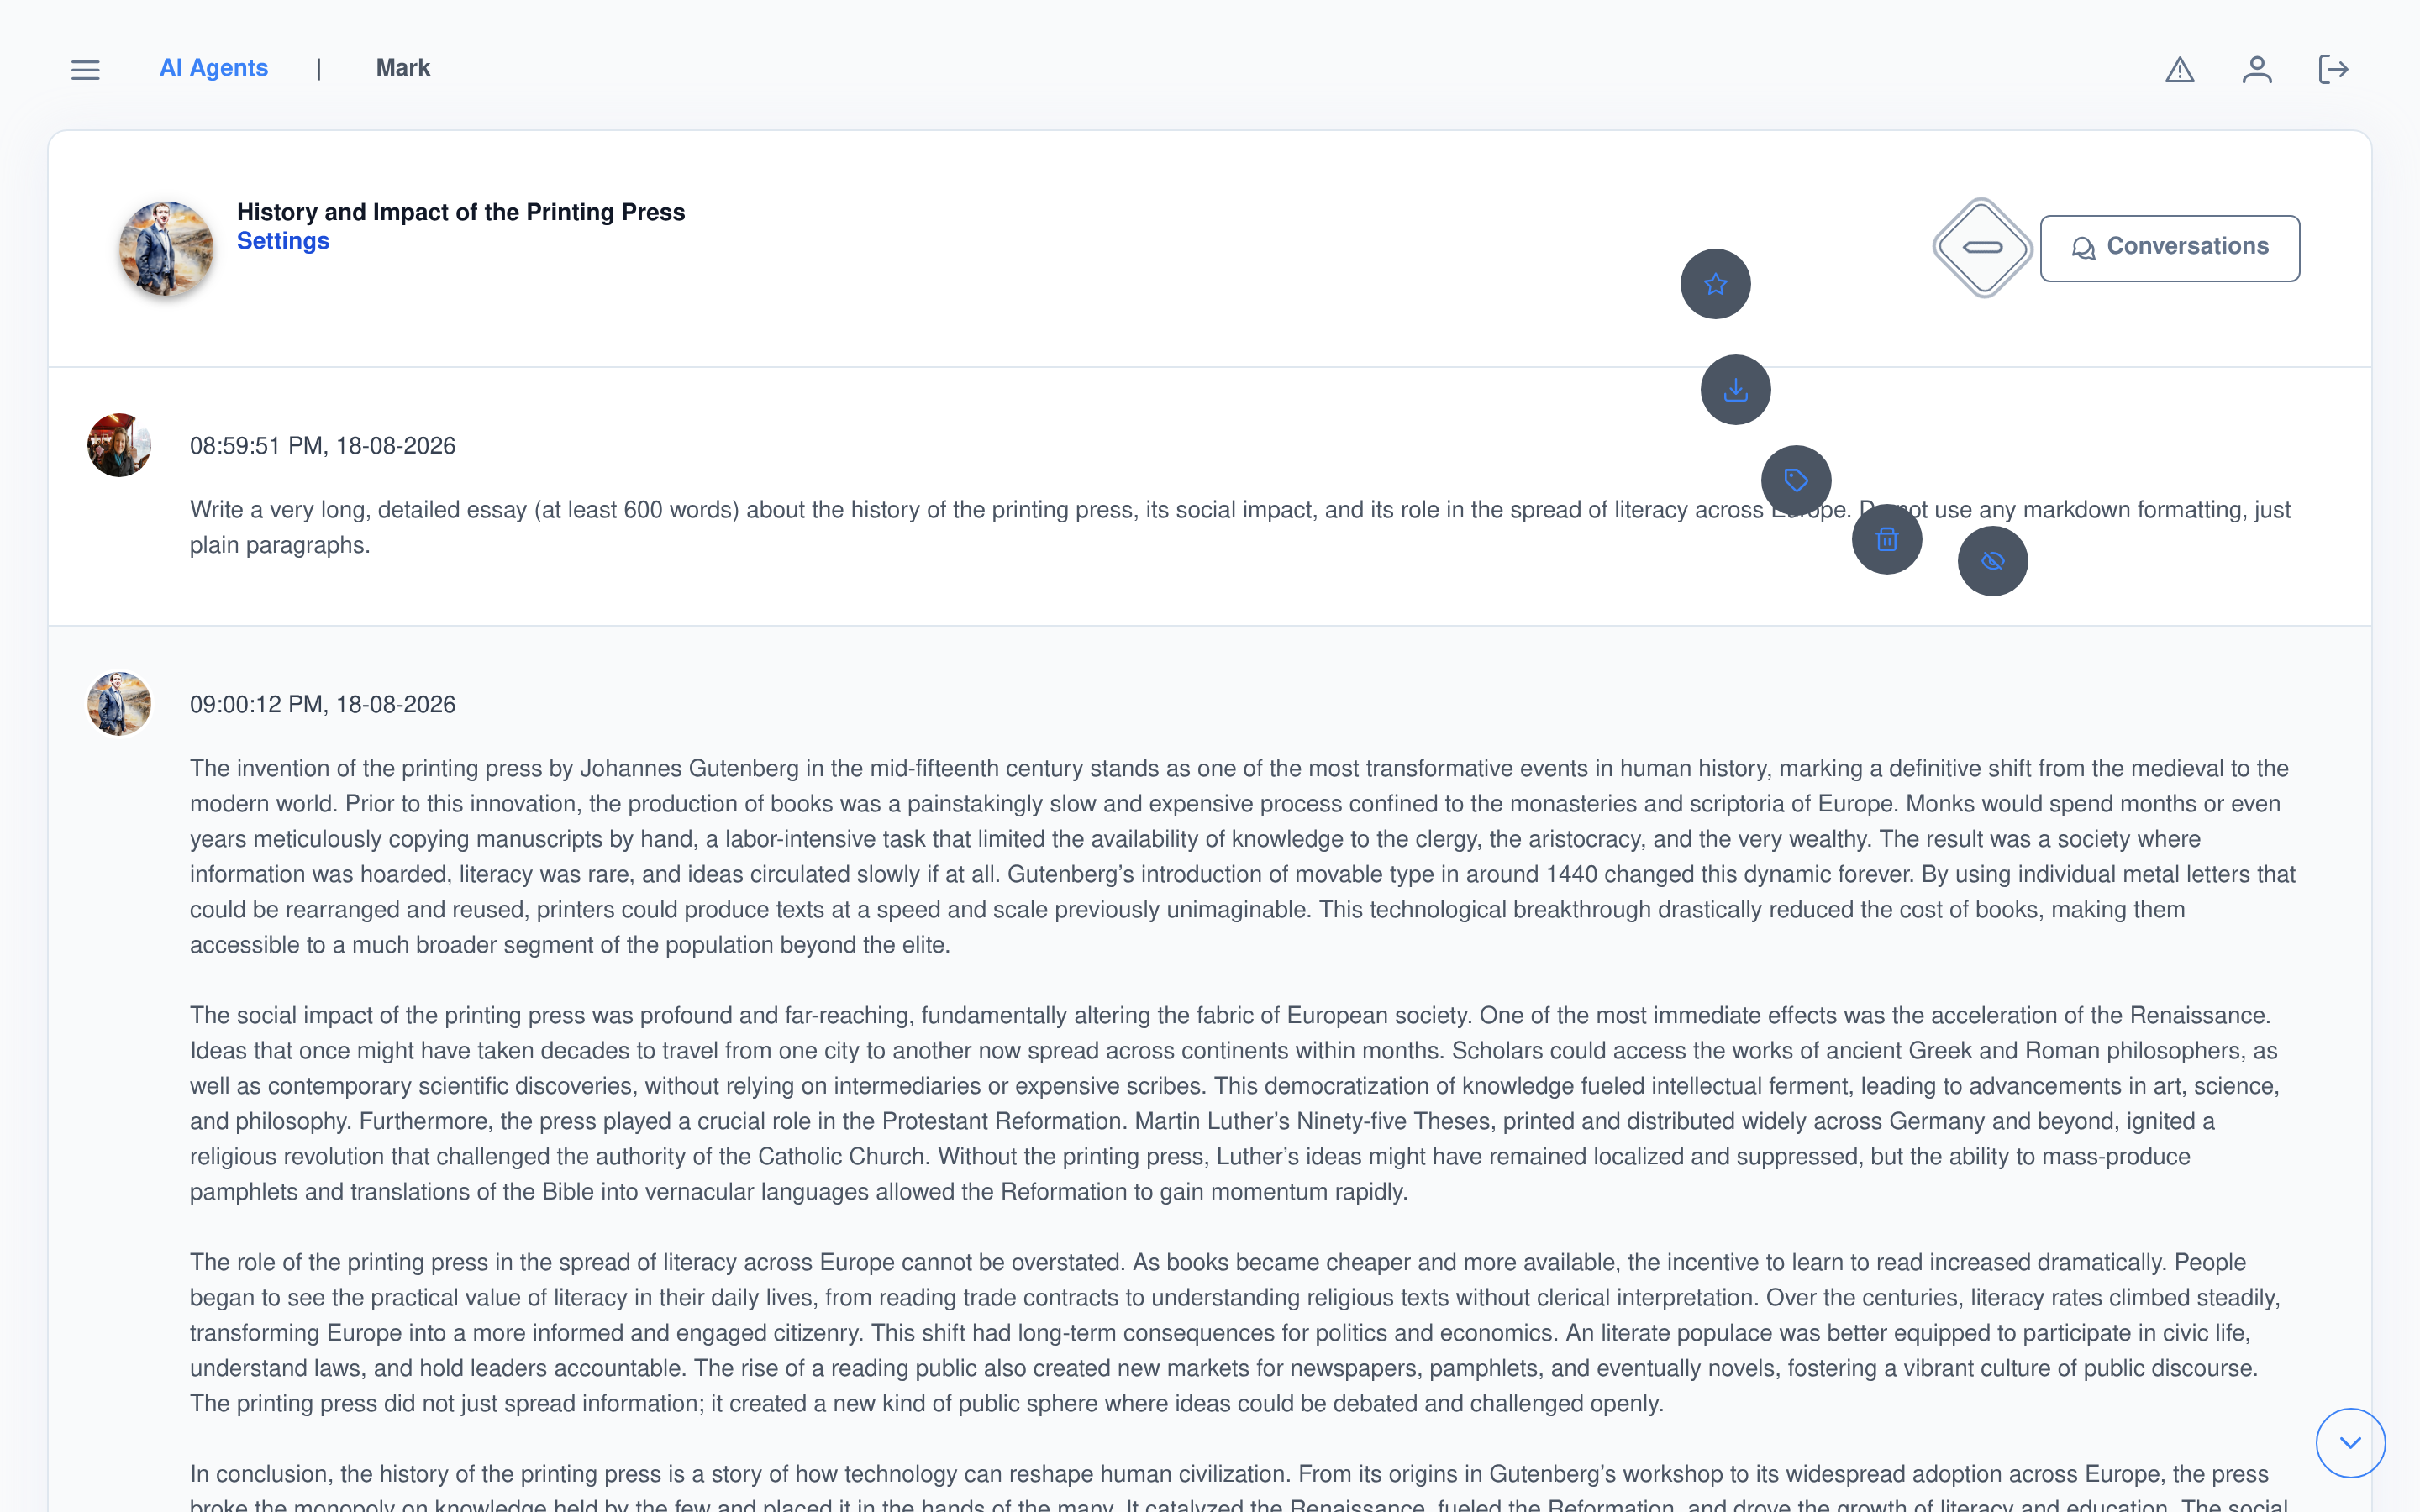
Archivieren, taggen, favorisieren oder exportieren — ein Wählrad, fünf Aktionen
Ein radiales Menü an der Konversations-Kopfzeile bündelt die Aktionen, die nicht in den Hauptablauf gehören: archivieren oder wiederherstellen, löschen, mit frei wählbaren Tags versehen, favorisieren und herunterladen.
- Der Download exportiert die vollständige Konversation als JSON — inklusive Systemnachricht — als Role/Content-Paare, bereit für jedes andere System.
- Archivieren und Löschen fragen beide zuerst nach, damit ein verirrter Klick keine Konversation kostet.
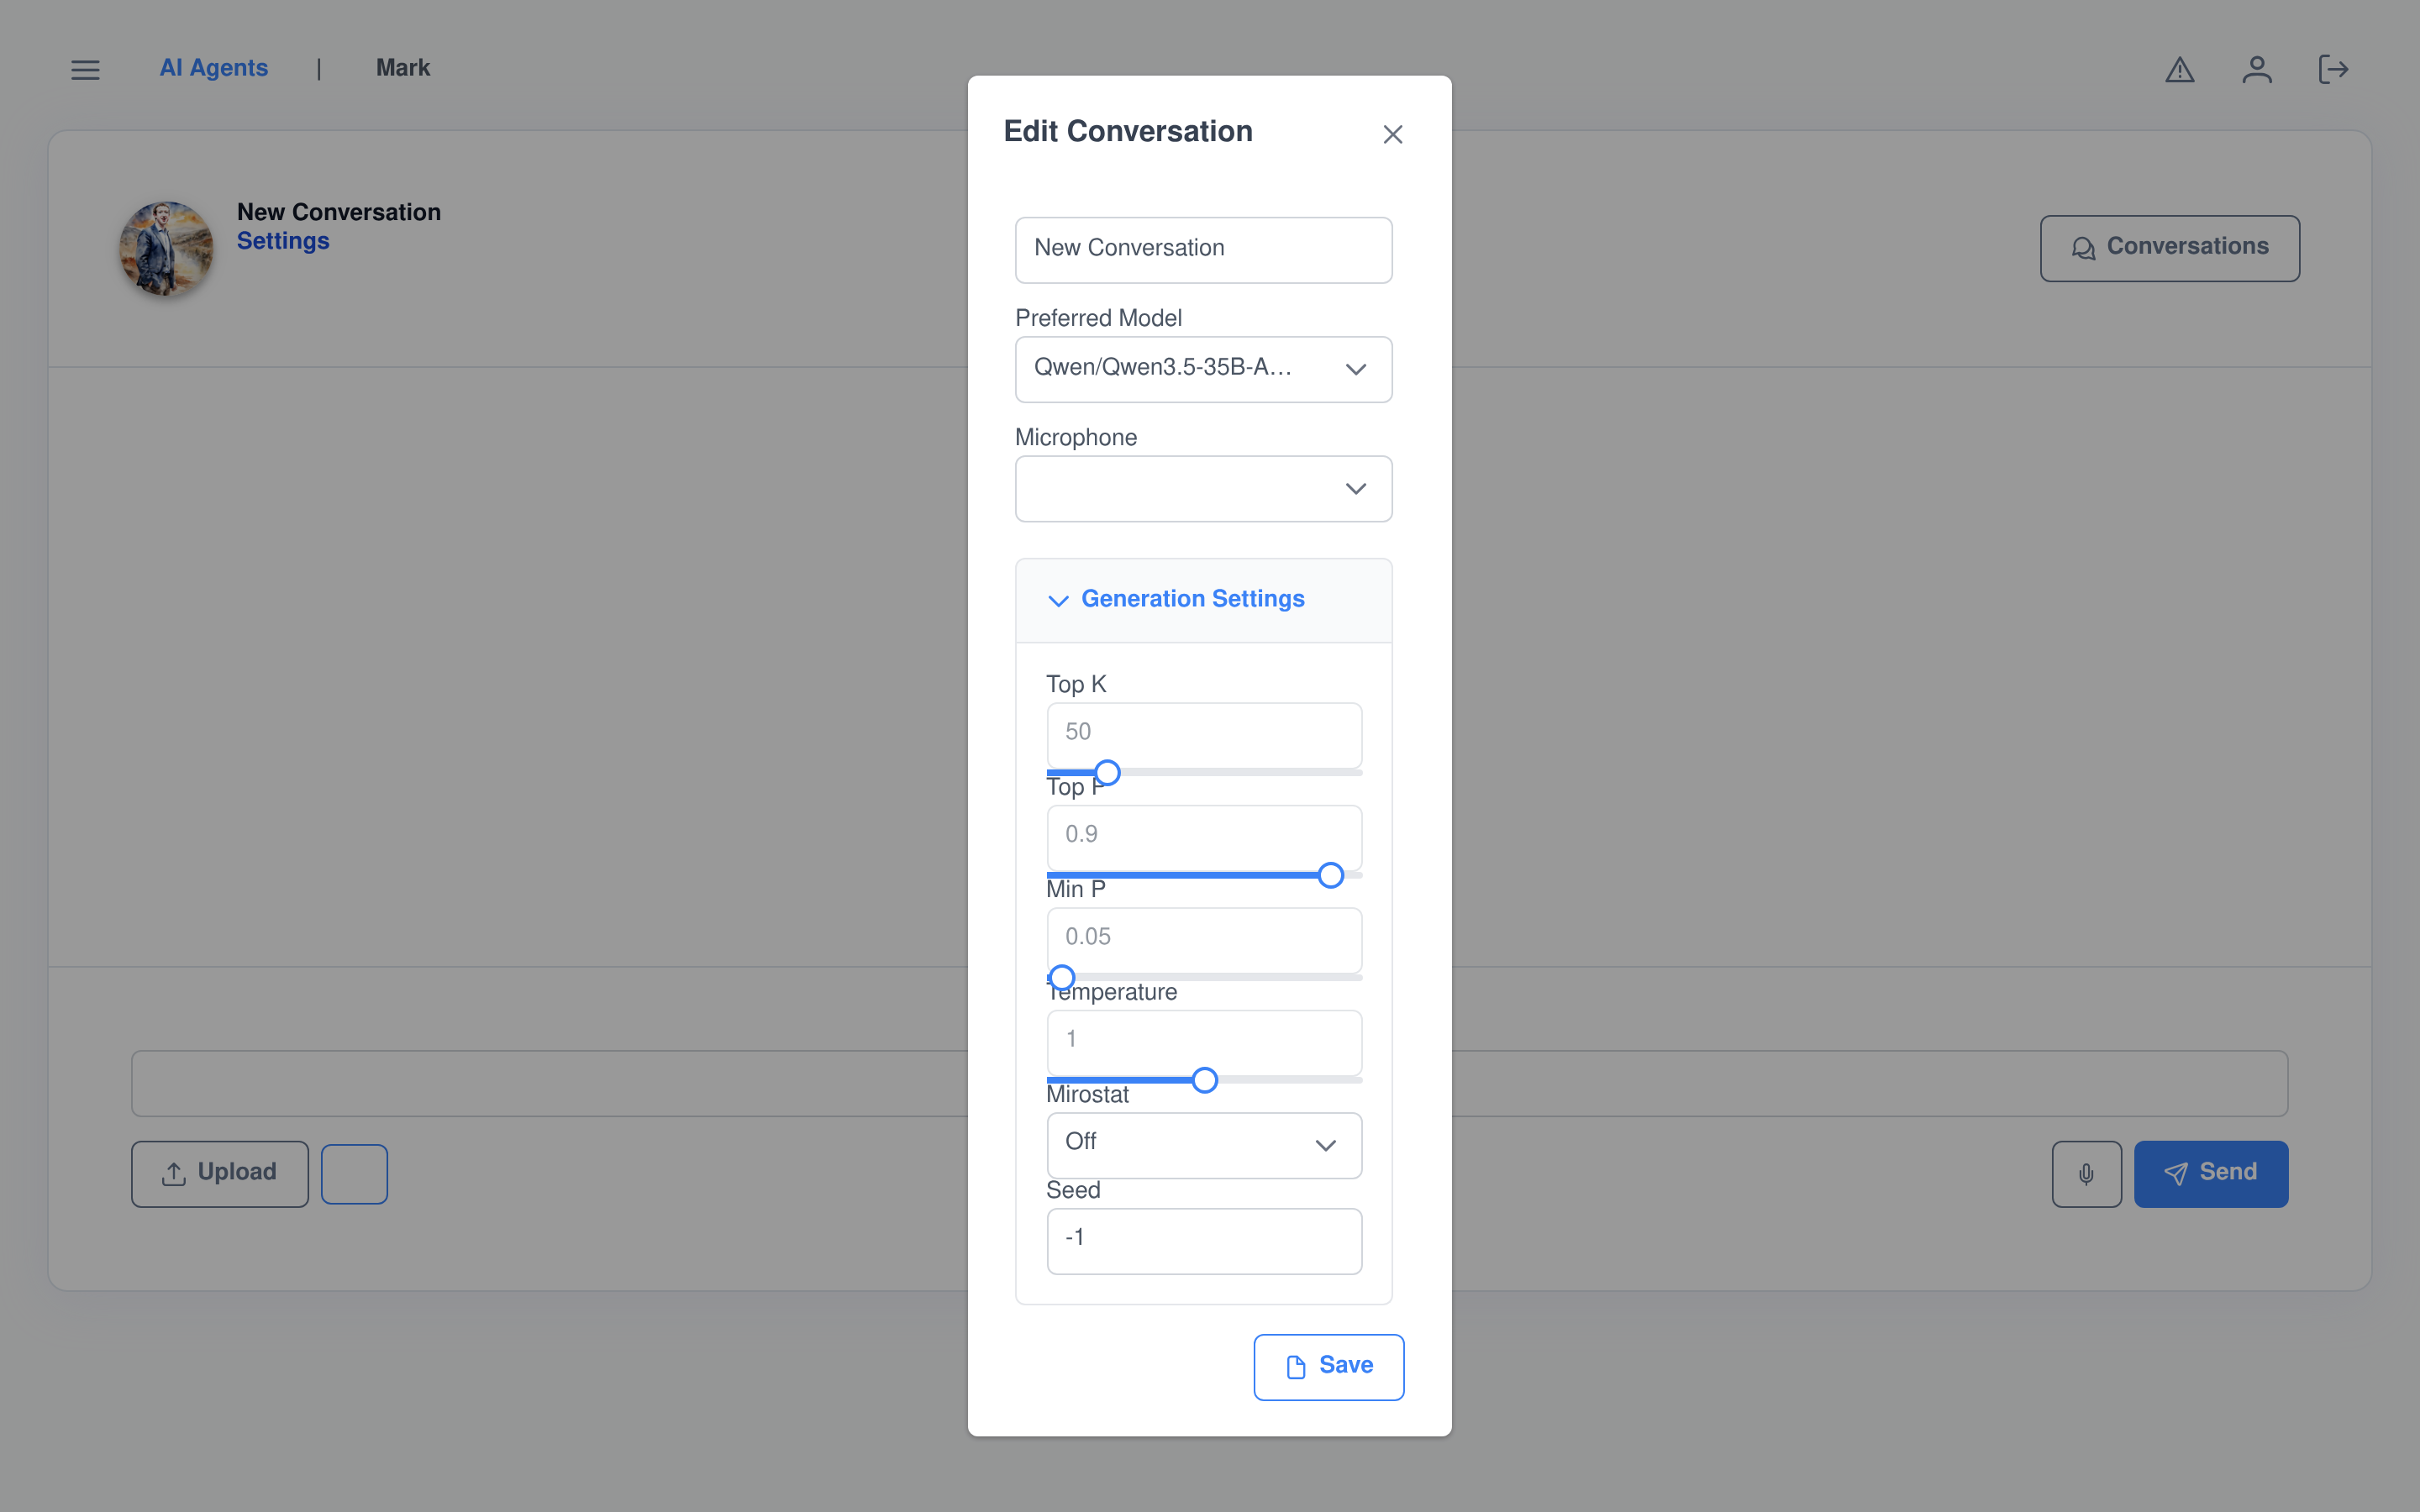
Das Modell pro Konversation überschreiben, nicht nur pro Agent
Der Settings-Link jeder Konversation öffnet einen Dialog, der die Standardwerte des Agenten nur für diese Konversation überschreibt: Thema, bevorzugtes Modell, Mikrofon, ein vollständiges Sampling-Akkordeon (Top K, Top P, Min P, Temperature, Mirostat mit eigenem Tau/Eta, Seed) und die Systemnachricht.
- Nichts davon verändert die eigentliche Konfiguration des Agenten — es ist eine Ebene pro Konversation, die darüberliegt.
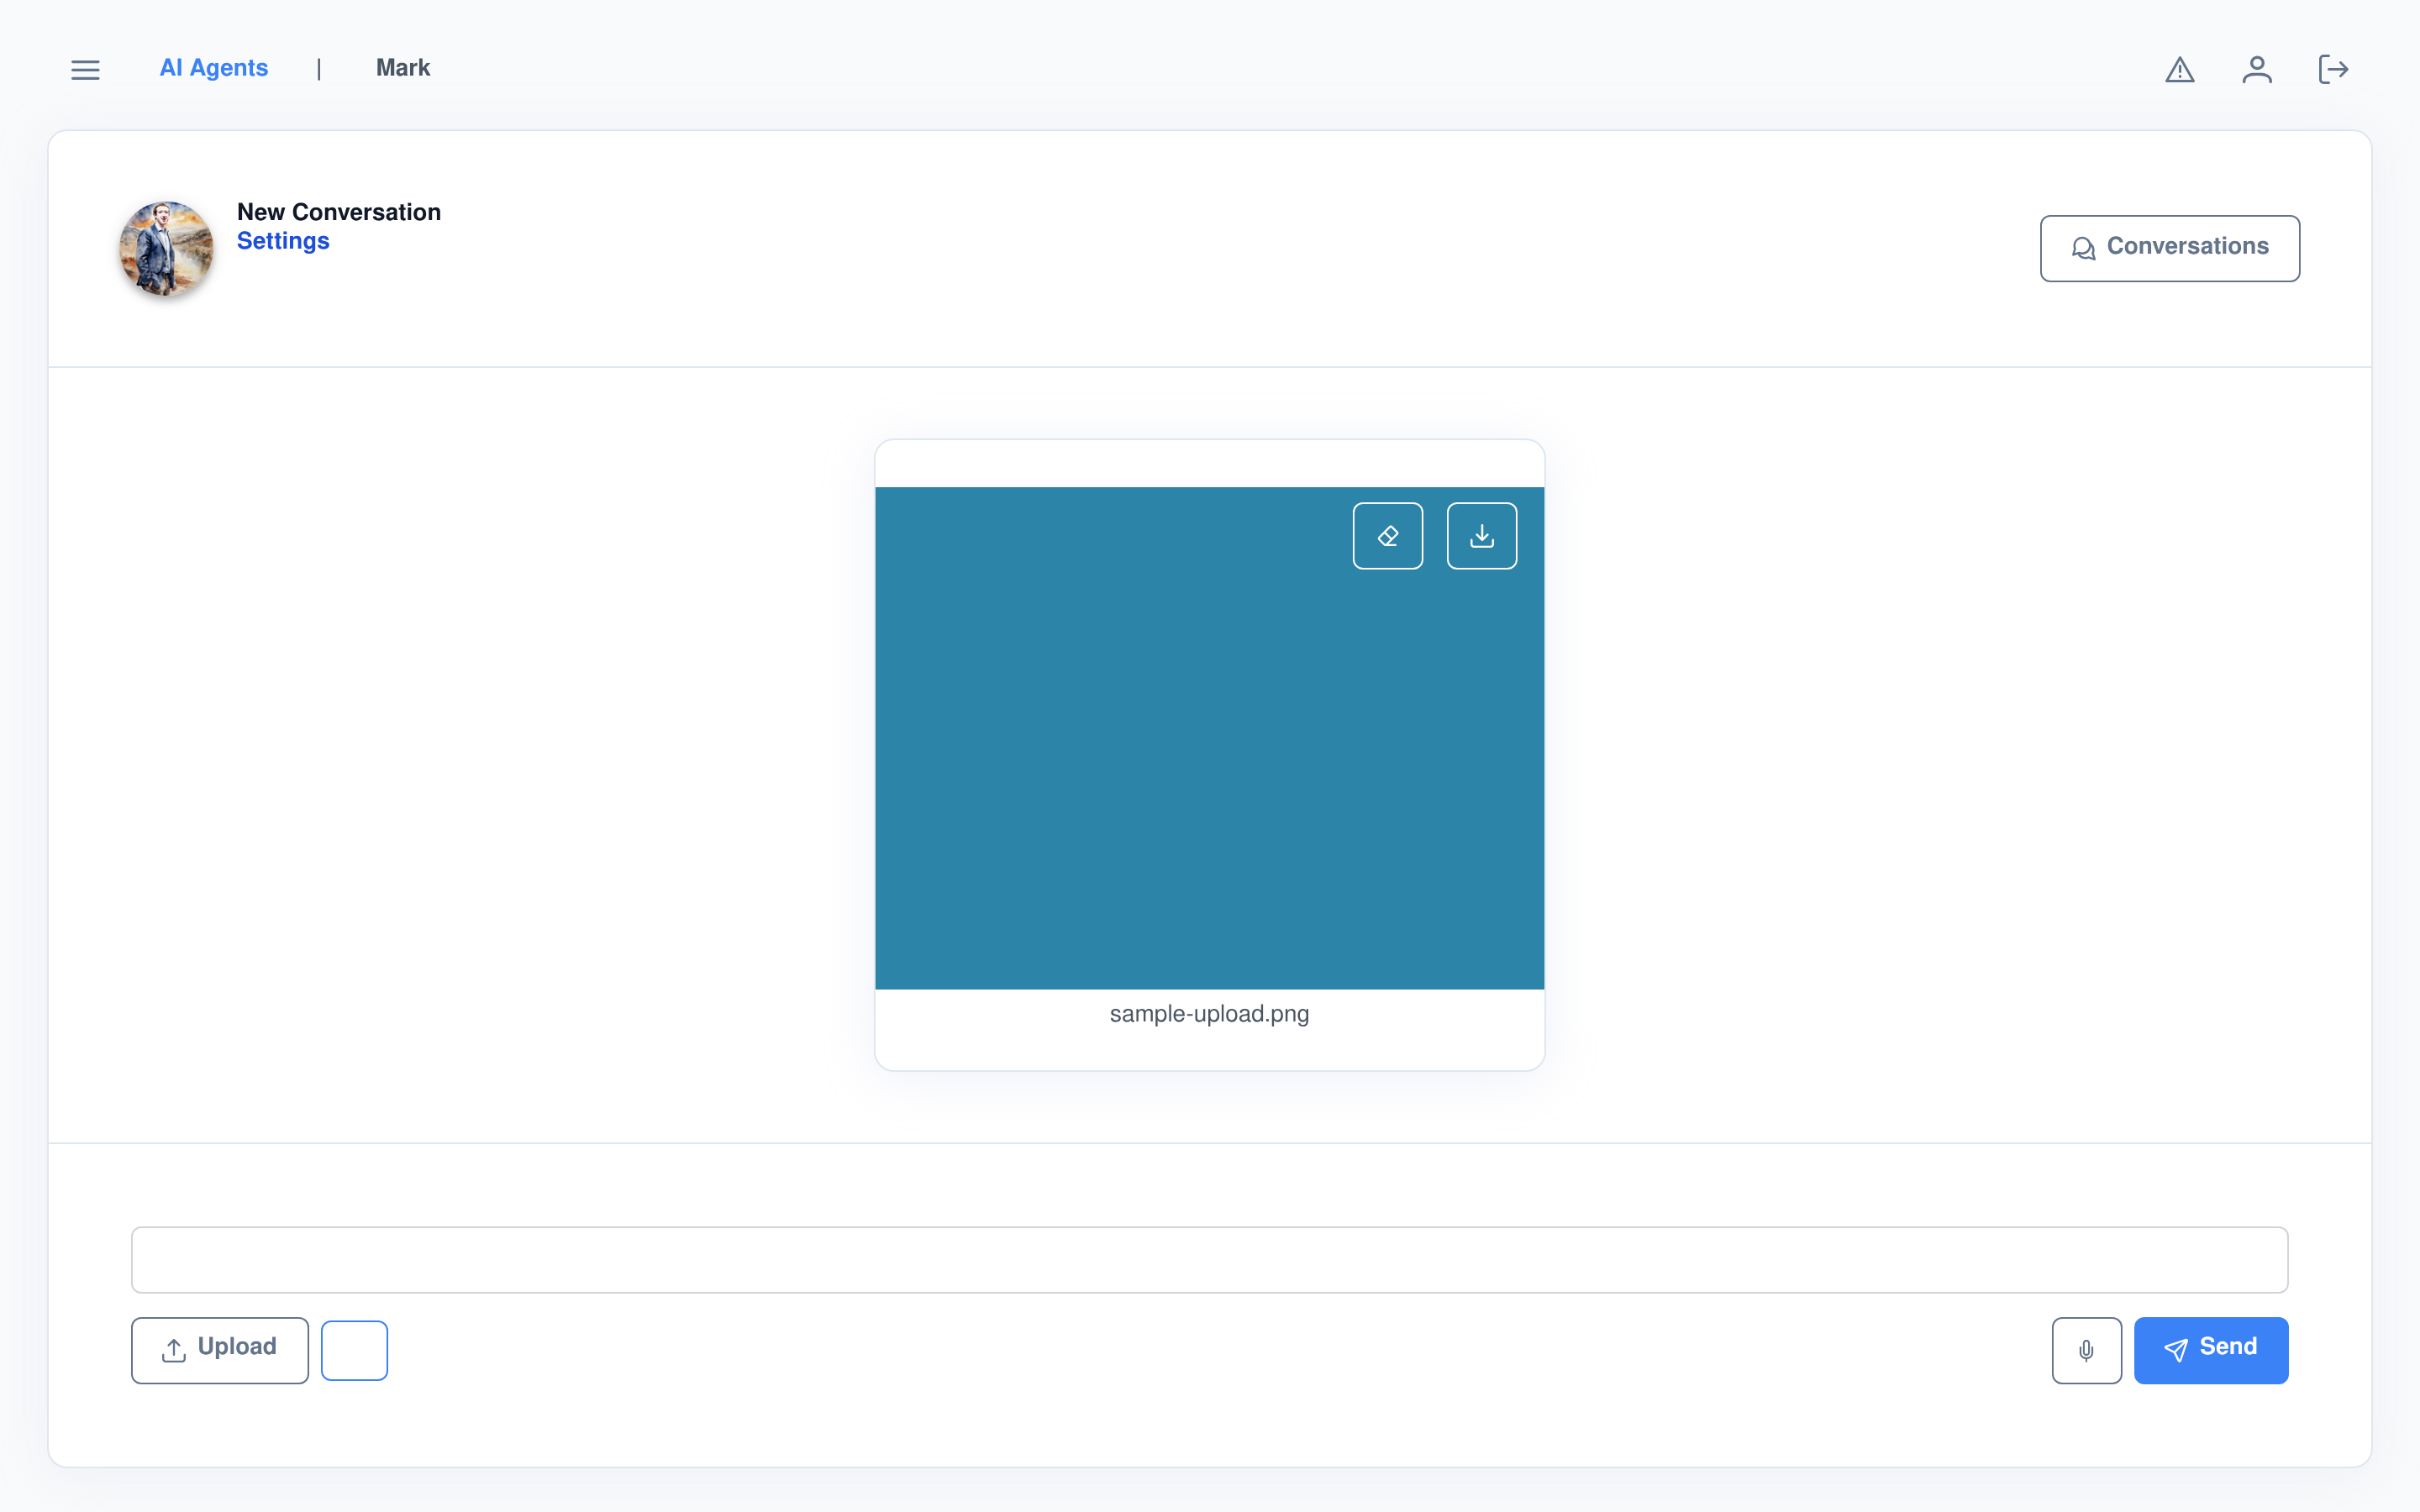
Bilder, Audio, Video, sogar 3D-Modelle — hineingezogen und gerendert
Ziehen Sie eine Datei auf das Eingabefeld oder klicken Sie auf Upload. Jeder Dateityp bekommt eine maßgeschneiderte Vorschau, keinen generischen Anhang-Chip:
- Bilder erscheinen in voller Größe mit Entfernen- und Download-Steuerung.
- Video bekommt einen nativen Player; Audio eine eigene Play/Stop-Karte.
- 3D-Modelle laden in einen AR-fähigen Viewer, den Sie direkt in der Konversation drehen und inspizieren können.
Sprache hinein, Sprache heraus
Aufnahme
- Eine Live-Wellenform während Sie sprechen; beim Loslassen geht die Aufnahme an das Spracherkennungsmodell des Agenten.
- Der Thinking Mode hat einen eigenen 🧠 / 🐇-Schalter, der nur erscheint, wenn das aktive Modell das Umschalten tatsächlich unterstützt.
Wiedergabe
- Gestreamtes Text-to-Speech-Audio wird Stück für Stück auf der rohen Audio-Uhr geplant, sodass aufeinanderfolgende Abschnitte ohne hörbare Lücke abspielen.
- Das Stoppen der Wiedergabe bricht auch den Rest der Generierung serverseitig ab, nicht nur das lokale Audio.
Bearbeiten und verzweigen, ohne das Bisherige zu verlieren
Ihre Nachrichten
- Eine frühere Nachricht bearbeiten und ab dort neu generieren — die vorherige Antwort wird nicht verworfen, sondern zu einer Geschwister-Version, zu der Sie mit einem
< 2 von 3 >-Zähler zurückwechseln können. - Löschen wird nur für Ihren jüngsten Beitrag angeboten, damit Sie nicht versehentlich tiefere Historie auslöschen.
Seine Antworten
- Wenn ein Agent es erlaubt, können Sie eine KI-Antwort in einem Roh-Text-Editor öffnen und direkt überschreiben — nützlich, um einen Fakt zu korrigieren, ohne den ganzen Austausch neu laufen zu lassen.
- Bewerten Sie eine Antwort mit einer Sterne-Bewertung, wenn der Agent Response-Rating aktiviert hat, oder kopieren Sie jede Antwort mit einem Klick in die Zwischenablage.
Eine Pause, bevor eine Fähigkeit tatsächlich läuft
Manche Fähigkeits-Aufrufe feuern nicht einfach los — sie halten an und fragen zuerst, direkt in der Konversation: „Execute AI Ability: <Name>“, mit der Wahl, den Aufruf auszuführen oder das Modell ohne ihn antworten zu lassen. Eine Human-in-the-Loop-Kontrolle, bevor etwas passiert — kein Protokoll dessen, was bereits geschah.
Für wen diese Oberfläche läuft
Alle, die mit einem Agenten sprechen
- Antworten mit korrekt gerenderter Mathematik und korrekt gerendertem Code — beim ersten Mal, ohne Kopieren in einen separaten Renderer.
- Eine lange Generierung unterbrechen, ohne sie zu verlieren — oder später zurückkommen und sie zu Ende führen.
- Jede Konversation per Tag organisiert halten und jede davon als JSON exportieren.
Teams, die sich auf eine Oberfläche festlegen
- Jeder Agent der Instanz — Coding-Assistent, Support-Bot, Recherche-Agent — teilt sich dieselbe Chat-Oberfläche.
- Modell- und Sampling-Overrides pro Konversation bedeuten: eine schwierige Konversation erfordert nicht die Neukonfiguration des ganzen Agenten.
Häufig gestellte Fragen
Rendert es LaTeX wirklich oder zeigt es nur den Rohtext?
Es rendert. LaTeX wird in einer Antwort automatisch erkannt und live mit MathJax gesetzt — Gleichungen erscheinen als Gleichungen, nicht als escapte Backslash-Befehle.
Verliere ich eine Antwort, wenn ich sie stoppe?
Nein. Alles, was vor dem Klick auf Stop generiert wurde, bleibt auf dem Bildschirm, und Continue Generation setzt exakt an diesem Punkt fort — ohne Neustart und ohne Wiederholung des bereits Vorhandenen.
Kann ich das Modell wechseln, ohne den Agenten zu bearbeiten?
Ja. Der Settings-Dialog einer Konversation kann das bevorzugte Modell und jeden Sampling-Parameter nur für diese Konversation überschreiben — die eigene Konfiguration des Agenten bleibt unberührt.
Was passiert, wenn ich eine frühere Nachricht bearbeite?
Das Bearbeiten und Neu-Generieren ab einer früheren Nachricht erzeugt eine neue Verzweigung, statt die alte zu überschreiben — ein Geschwister-Zähler lässt Sie zwischen allen Versionen dieses Beitrags hin- und herschalten.
Bekomme ich meine Konversationsdaten heraus?
Ja. Die Download-Aktion der Konversation exportiert sie als JSON, inklusive Systemnachricht, als Role/Content-Paare — kein Auslesen der Seite nötig.
Starten Sie eine Konversation
Die Chat-Oberfläche ist Teil jeder Assistant-Cortex-Instanz — kein separates Chat-Widget, das integriert werden müsste.